作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3280 字 | 预计阅读 8 分钟,后有完整脚本和复现数据,建议先收藏
你让 AI 给一堆股票打分,第一名90.1分,第二名88分,第20名72分。但再问权重如何配、池子怎么筛、数据缺了怎么补总它有几个是瞎编或者说不清楚的。
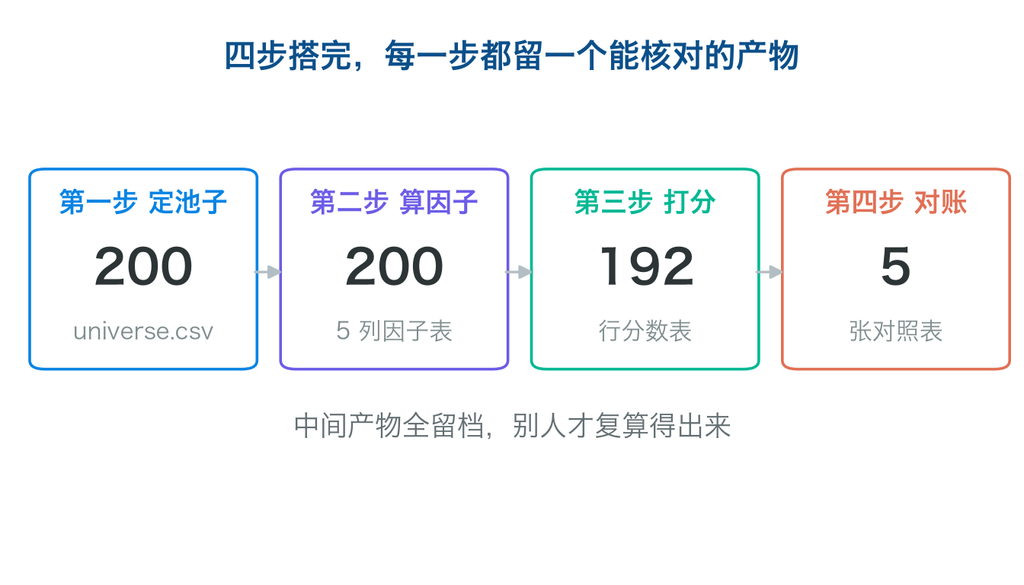
想写这篇,是因为能给股票打分的 AI 越来越多,但支持查账的不多。一套选股器说到底就四件事,定池子、算因子、打分、对账。往下我按这个顺序拆一遍,每一步给能跑的代码和能核对的中间文件,跟着我走完你手上会多一个自己的选股器。
第一步,把股票池划定
一个选股器最先要定的不是因子,是一批股票。
这一步决定后面所有事情。换一个池子,排名整张重来。同一套因子在沪深 300 里选出来的第一名,放到全市场里可能连前 100 都进不去。
我今天举例的规则定三条。总市值 500 亿以上,剔除 ST、退市和北交所,取市值最大的前 200 只。日期锁在 11 月 6 日收盘。
第三条最容易被忽略。市值排名每天都在动,今天筛出来的 200 只和明天筛出来的不是同一批。快照日期不写死,你复算时池子已经换了,分数自然对不上。
def build_universe(n=200):
    spot = ak.stock_zh_a_spot_em()
    bad = spot["名称"].str.contains("ST|退")
    spot = spot[~bad]
    spot = spot[spot["总市值"] > 5e10]
    return spot.nlargest(n, "总市值")
有个替代做法要提醒一句。很多人图省事,直接拿沪深 300 成分股当池子。这个做法省事,代价是让编制方替你做了筛选。成分股每半年调整一次,调进来的往往是已经涨过的,调出去的往往是已经跌惨的,你拿它当池子,等于先接受了一次幸存者偏差。
跑完这一步,你应该有一个 200 行的 csv,代码、名称、市值、市盈率都在里面,文件名带上快照日期。后面每一步都从它读。
第二步,五格各一条公式
这一步把每只票变成五个数。
每个数都要写成一条能复算的公式,不能停在概念上。“盈利质量好”不是公式,“ROE 等于净利润除以净资产”才是。
| 因子 | 怎么算 | 翻译成人话 |
|---|---|---|
| 动量 | 半年前到一个月前的涨幅 | 这半年涨得好不好 |
| 质量 | ROE | 每一块钱净资产能赚回多少 |
| 成长 | 营收同比增速 | 生意还在不在长 |
| 估值 | 市盈率除以同行业中位数 | 比同行贵还是便宜 |
| 情绪 | 近 20 天日均成交额除以近 250 天 | 钱有没有往这边涌 |
动量这一格的窗口值得单独说。它从 130 个交易日前算到 22 个交易日前,中间跳过了最近一个月。6-1 这个写法我第一次看的时候没看懂,以为是六个月减一个月,对着代码推了两遍才对上,它的意思是截到一个月前、再往前数半年。
跳过最近一个月,是因为短期涨跌容易反转。这一个月里最猛的票,下一个月常常是最弱的,把它算进来,动量因子测到的就不是趋势,是噪声。
估值这一格除以了同行业中位数,芯片股 25 倍算便宜、银行 25 倍算贵,绝对值摆在一起没法比,不做这一步,排出来的就是一张行业偏好表。
情绪这一格是改过的。A 股没有现成的逐日新闻情绪打分,我换成成交额放大倍数,近 20 天比近 250 天。它只测到了钱,没测到话。这是全套里最弱的一环,我不敢说它跟新闻情绪等价。
def feats(code):
    pre = "sh" if code[0] == "6" else "sz"
    d = ak.stock_zh_a_daily(
        symbol=pre + code,
        start_date="20250101",
        adjust="qfq",
    )
    c = d["close"].values
    a = d["amount"]
    mom = c[-22] / c[-130] - 1
    recent = a[-20:].mean() / a[-250:].mean()
    return {"mom": mom, "senti": recent - 1}
跑完这一步,200 只票里 191 只能算出完整的五个数。少掉的 9 只上市不满一年,日线凑不够 130 根。这 9 只怎么处理是第三步的事,先记着。
手上应该有一张 200 行 5 列的表,带代码和日期,存成 csv。
第三步,五个数压成一个分
这一步把五个数变成一个 0 到 100 的分数。
做法是百分位排名。每一项在全体样本里排第几,换成 0 到 1 之间的小数,再乘权重加总。不直接用手上的原值,是因为 ROE 是百分数、成交额是亿元、市盈率是倍数,量纲不一样,直接相加没有意义。
百分位还有个好处,好懂。动量的百分位是 0.73,意思是这只票的半年涨幅打败了 73% 的同行,不用管它到底是涨了 40% 还是 4%。
权重是 25、25、20、15、15。这个比例是拍的,不是算出来的,后面的对账会告诉你它其实没那么要紧。
W = {"mom": .25, "roe": .25, "growth": .2,
     "pe": .15, "senti": .15}

r = pd.DataFrame({
    "mom": d["mom"].rank(pct=True),
    "roe": d["roe"].rank(pct=True),
    "growth": d["growth"].rank(pct=True),
    "pe": (-d["rel_pe"]).rank(pct=True),
    "senti": d["senti"].rank(pct=True),
}).fillna(0.5)

d["score"] = sum(r[k] * w * 100
                 for k, w in W.items())
三行细节,每一行都会改变结果。
第一行之前先剔掉市盈率为负的票。亏损公司的市盈率没有意义,留着会污染估值的排名。200 只里剩 192 只。
.fillna(0.5) 是给缺数据的票一个中位分。前面那 9 只没有动量的票,就靠这一行进了排名。这个 0.5 我一开始是照抄的惯例,后来才想明白它意味着什么。
(-d["rel_pe"]).rank() 里的负号,是把“市盈率越低越好”翻成正序。少写这个负号,估值最高的一批会排在前面。
分数出来之后,第一件事是拆开看。
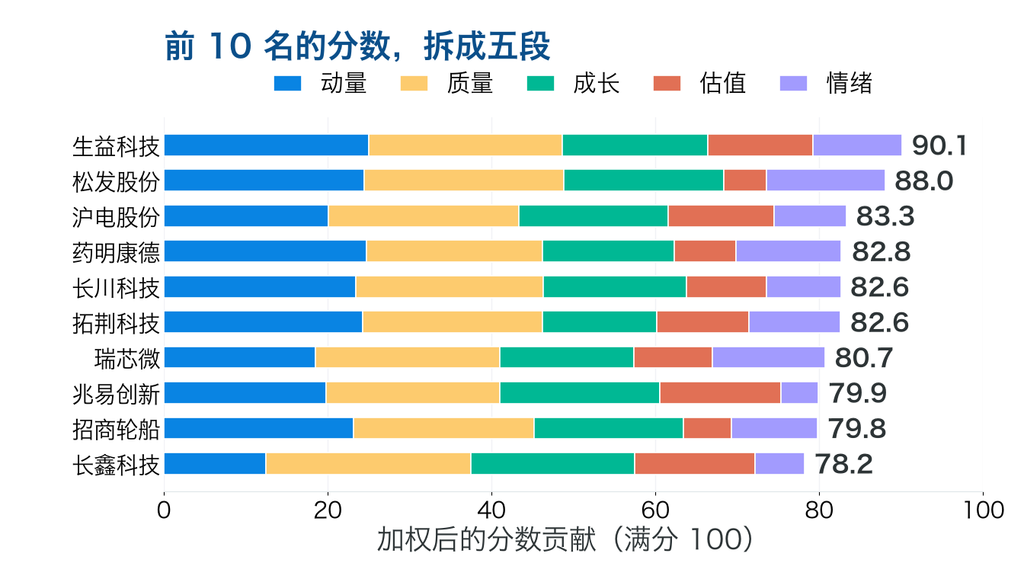
第一名 90.1 分,五段里动量最长。第三名 83.3 分,成长那段最长,动量只占一小截。同一个分数,来源完全不一样,这就是能拆开的价值。
手上应该有 192 行带分数的表,按分数降序,存成 csv。
第四步,让每一格都能对账
前三步给出一个答案,这一步验证这个答案有多结实。
对账要回答三个问题。这个分数拆开是什么样,上面已经看过了。换一个参数名单会怎么动。偏离是模型的错,还是市场的真实状态。
做法是一次只改一个参数,重跑一遍,看前 20 名重合几只。
| 改动 | 前 20 名重合 | 秩相关 |
|---|---|---|
| 权重改全等权 | 18 只 | 0.986 |
| 去掉动量因子 | 16 只 | 0.891 |
| 估值直接比市盈率 | 16 只 | 0.948 |
| 动量窗口改 6-0 | 14 只 | 0.958 |
| 缺失动量改填 0 | 17 只 | 0.989 |
这张表就是“能查账”的证据。任何一个人拿它去改参数,都会得到同一组数。
五组里挑三组细说,另外两组数字就在表上。先看第一行。权重从 25/25/20/15/15 改成全等权,前 20 名重合 18 只。看到这个数我第一反应是脚本没刷新,重跑一遍,还是 18。
这个结果和直觉不太一样。多数人以为调权重是头等大事,调完能换一批票。实际换的是 2 到 4 只,剩下 16 到 18 只原封不动。
再看窗口那一行。动量窗口从跳过最近一个月改成算到昨天,前 20 名只剩 14 只重合,一次换掉 6 只。
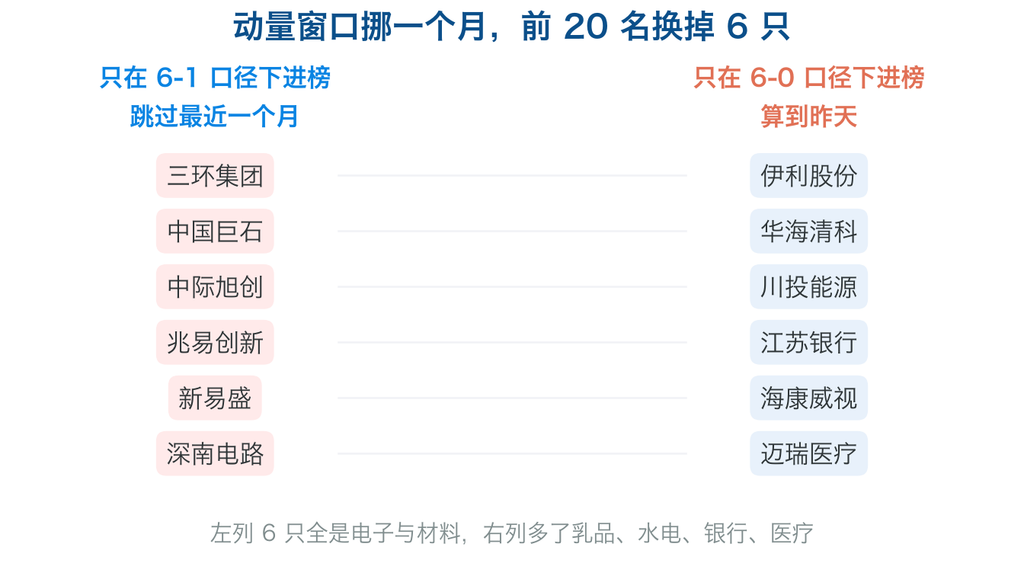
掉出去的 6 只是三环集团、中国巨石、中际旭创、兆易创新、新易盛、深南电路,5 只电子,1 只玻纤。补进来的 6 只是伊利股份、华海清科、川投能源、江苏银行、海康威视、迈瑞医疗。
一个减法,把光模块和 PCB 换出去几只,换进来乳制品、水电、城商行、医疗器械,外加两只电子设备。
我原本以为窗口是个技术细节,跑完才发现它比权重狠得多。权重调完秩相关 0.986,窗口一改只有 0.958,换掉的名单从 2 只变成 6 只。
那两个数字摆在一起,意思很清楚。你在调参界面上能拧的那个旋钮,往往不是最要紧的那个。
最后一行是另一种情况。11 只票上市不到一年,算不出半年动量,代码给它们填了 0.5。其中 3 只进了前 20,第 10 名的长鑫科技、第 18 名的大普微、第 19 名的联讯仪器。
把 0.5 改成 0,缺失按最差算,这 3 只的排名从第 10 掉到第 27,第 18 掉到第 47,第 19 掉到第 52。
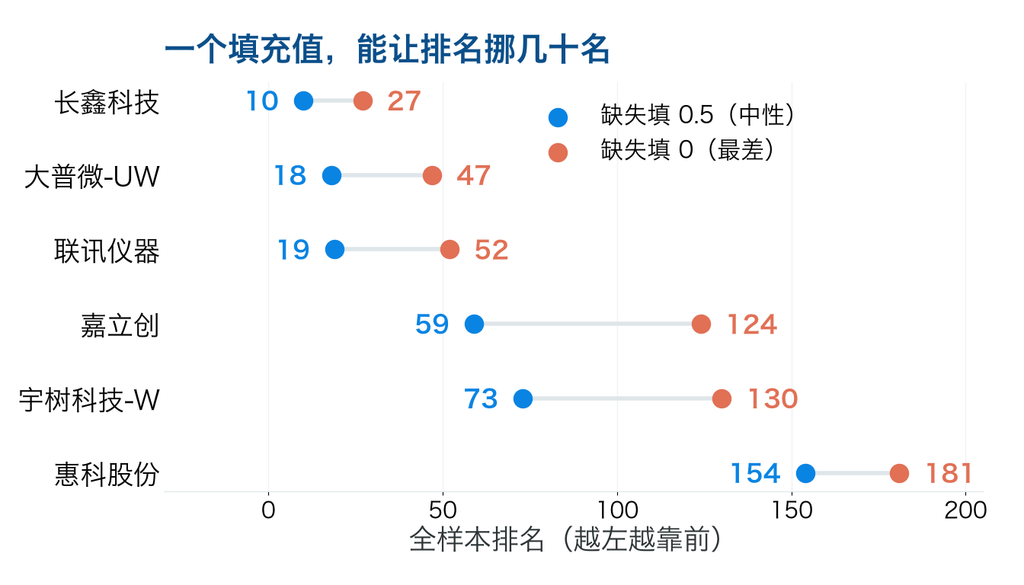
可整张表的秩相关还有 0.989。因为全局指标几乎没动,只有那 3 只在换位置。全局指标最容易骗人的地方就在这儿,它会把少数人的大幅移动平均掉。你要只取前 20,那 3 只就是三次换仓。
0.5 和 0 哪个对,我没有答案。0.5 的道理是不奖不罚,0 的道理是没数据就是不知道,不知道就该排在知道后面。两个说法都站得住,但选哪个,直接决定三只票进不进榜。一行 fillna,写成什么值,得有人负责。
最后看行业,也就是第三个问题,偏离是模型的错还是市场的状态。
半导体在池子里 22 只,占 11%,前 20 名里 6 只,占 30%。这个 30% 我看了好几遍才敢写,怕是自己分组分错了。元件在池子里 8 只占 4%,前 20 名里 4 只占 20%。银行 22 只占 11%,前 20 名里 0 只。电力 14 只占 7%,也是 0 只。
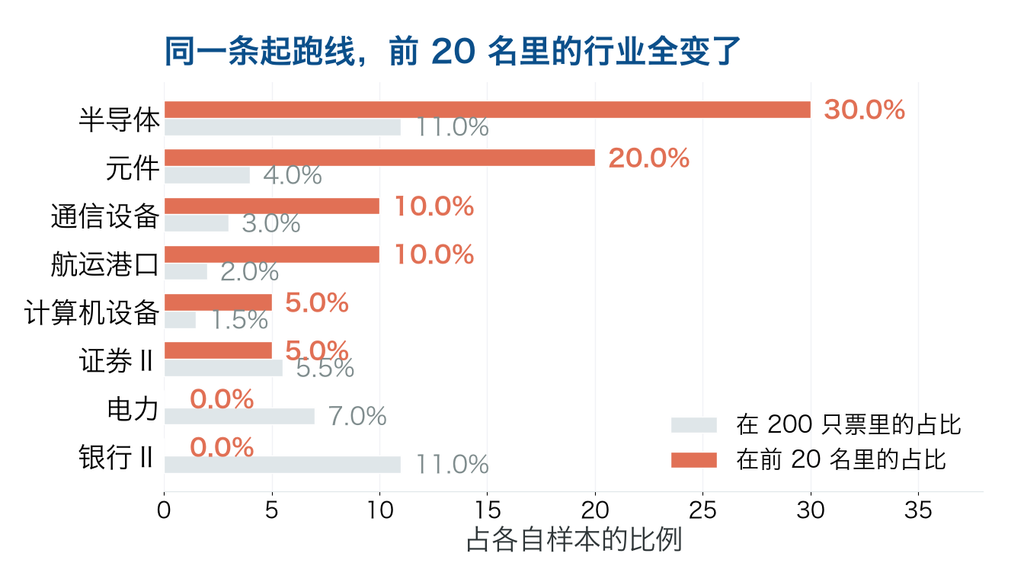
把半导体、元件、通信设备、消费电子、光学光电子、计算机设备合起来算,48 只,占池子 24%。前 20 名里占 13 只,65%。
模型没坏。存储、PCB、光模块这几条线今年在动量、成长、情绪三个方向上同时靠前,因子模型奖励的正好是这个。它诚实地把当下的景气排了出来。
但你要是照着前 20 只配,配到的不是分散组合,是一个 AI 硬件周期的赌注。
这一步跑完,手上有五张对照表,每张都能复算。到这儿,才谈得上“查账”。
解释层放最后,只写理由
分数出来之后,很多教程的顺序是把票丢给大模型,让它挑。
我反过来。先算完分,再让模型解释其中一只,只把这一个的数字给它,别的都不给。
prompt = f"""只用下面的数据写四句话,
说明这只票为什么排得高,以及最大的
风险。不要用数据里没有的数字。
{json.dumps(facts, ensure_ascii=False)}"""
它犯的错是这样的。把 0.735 写成 73.5%,把 1.635 写成“上涨 1.635”。一个是把情绪分当成了百分比,一个是把倍数当成了涨幅。
全是格式错误,没有编造。第一次看到这两处,我当时以为它算错了,回头翻 prompt 才发现是我自己没写清单位。
原因很简单,所有数字都是我喂给它的,它没有编造的余地。约束在数据上,模型的错误就从危险降级成难看,改一下就行。
真让它去查市盈率,上一季、记错的、算错的都会来,最难办的是看不出来。
观点总结
有三件事得说清楚。
第一,这不是回测。分数用的是今天的财报和今天的价格,拿它去对历史收益,等于用后视镜开车。真要做回测,得用当时的财报快照,还得把退市的票留在样本里。
第二,权重和窗口都是选择,不是真理。25、25、20、15、15 换一套,名单换 2 只。窗口那个 22 天和 130 天,说不好就是最优的,它是我沿用下来的惯例。
第三,行业集中是模型的诚实,不是它的错。它只是把偏差摆出来了,偏差本身来自市场当下在奖励什么。
这三条说完,能查账的标准其实只有一条。任何一个人拿着同一份数据,能复算出同一个分数。
做不到这一条,分数再高也只是排版。
这套东西的关键不在脚本,在参数怎么定。四步的代码我留在本地,参数一条条写死,改哪个都留痕。你要是照着重跑,跑出不一样的数字,多半是我哪里没交代清楚。
你手上的池子里,前 20 名有几只来自同一个行业?
觉得有用的话,把这篇转给同样在搞量化的朋友。
#AI选股 #多因子模型 #Python量化 #akshare #因子打分 #A股数据 #量化选股 #LLM应用 #开源复现 #量化工具实测
Be First to Comment