作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。
模型评测不等于投资建议。
不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文 2650 字 | 预计阅读 6 分钟,后有3段代码和数据来源,建议先收藏
我用今天要介绍的这个模型,把微软股票的模拟跑完后,屏幕上并排跳出两个一模一样的数字:28.1%。一个是模型说的一年後亏损概率,一个是它报出的年化波动率。
前一个回答“一年后亏钱的可能性有多大”,后一个回答“股价平时有多颠”。我第一次看到这两个 28.1% 时,手在键盘上停了一下。直觉告诉我:坏了,是不是把波动率直接填进亏损概率那一栏了?后来公式推翻了这个直觉。但两个数字重合的那一瞬间,我记住了。
真正管亏损概率的是一条正态分布公式,代进去算出来是 27.59%。所以那两个 28.1% 只是巧合。
这套东西我是真跑完了:数据自己拉,代码自己写,1000条路径、252个交易日,一个环节都没省。
一、这个模型到底在算什么
它一共只有三个零件。第一个是增长率,算法的形状很简单,留存率乘以ROIC。留存率是赚的钱里有多少留下来继续投,ROIC是投进去的每一块钱能赚回多少。两者相乘,大致就是这家公司能长多快。微软的留存率是79.72%,ROIC是25.92%,相乘得20.67%。
第二个零件是波动率,拿最近5年1255个交易日的日对数收益做标准差,年化之后是28.10%。
第三个零件是随机过程。股价走的是几何布朗运动,写出来是 dS/S = g·dt + σ·dW,g是刚才那个增长率,σ是波动率。这公式不直接算最终价格,它做的是把一年切成252个交易日,每天往前挪一小步,挪满252步。
挪这一步用的是Euler-Maruyama方法。它是把连续的随机过程一步步离散化的算法。换个说法,每天掷一次骰子,把掷出来的随机数加到价格上。
为什么不直接用闭式解算终值?因为闭式解只能给你最后那个数,中间怎么走的一概没有。而这中间的一段才最有意思,路上最大回撤多少、半年的时候价格在什么位置,都记在上面。
第四个其实不算零件,是个选择。跑1000条路径,看终值落在哪。
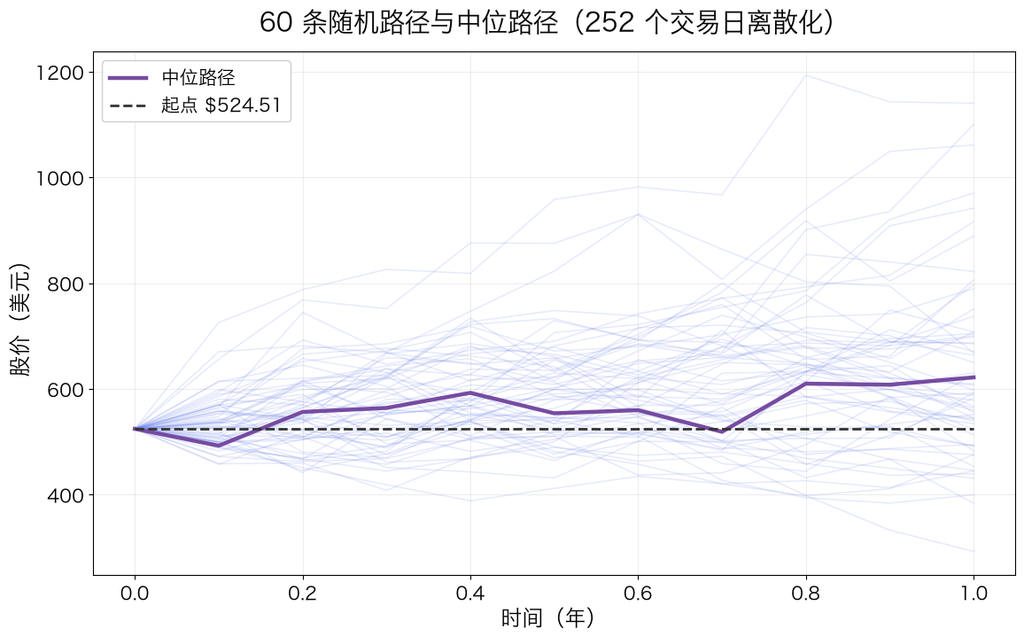
这图上画了60条随机路径,淡色是各自走出来的形状,深色那条是中位路径。同一个起点,能走出的形状差别很大。
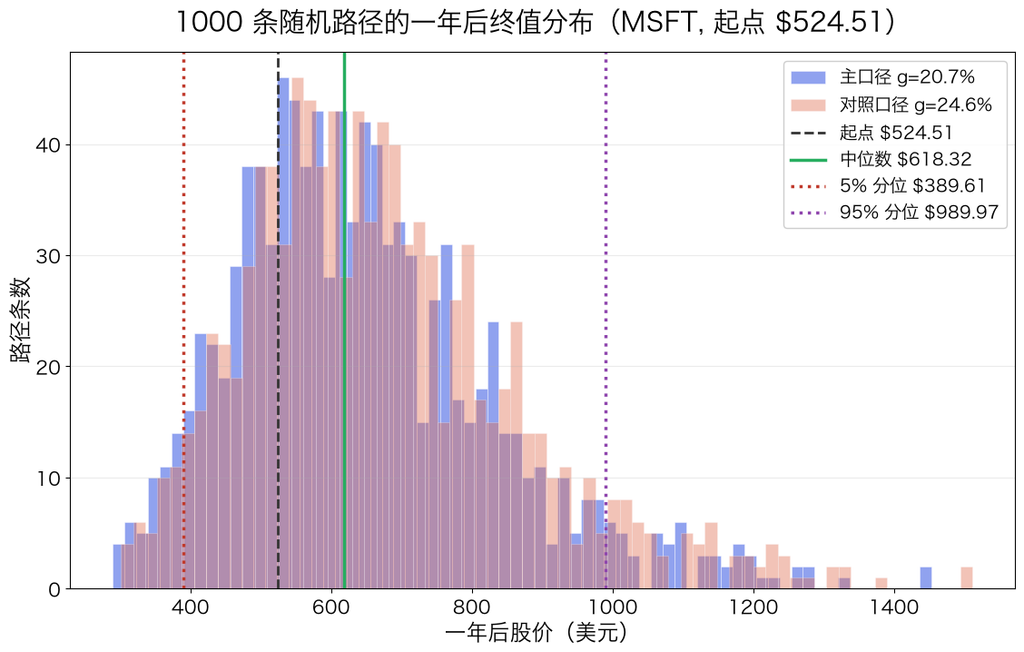
把1000条路径的终点叠在一起,就是这张分布图。起点524.51美元,均值645.11美元,中位数落在618.32美元。5%分位389.61美元,95%分位989.97美元。手上放一万美元,一年后组合的中位数是11788.51美元。
二、增长口径差4个点,结论就变了
这里有个我一开始踩的坑。第一次算出g是24.58%,跟那个20.7%差了4个点,以为是哪里取数错了。查了两天才发现是口径问题,不是错误。
ROIC的分母叫投入资本,算的是股东权益加上有息负债。争议在这儿,现金要不要扣。
扣掉现金和短期投资,微软的投入资本是4058.4亿美元,ROIC算出来30.83%,g就是24.58%。不扣的话,投入资本4826.8亿美元,ROIC降到25.92%,g是20.67%。
用的是不扣现金那版,我确认过,20.67%和20.7%能对上。
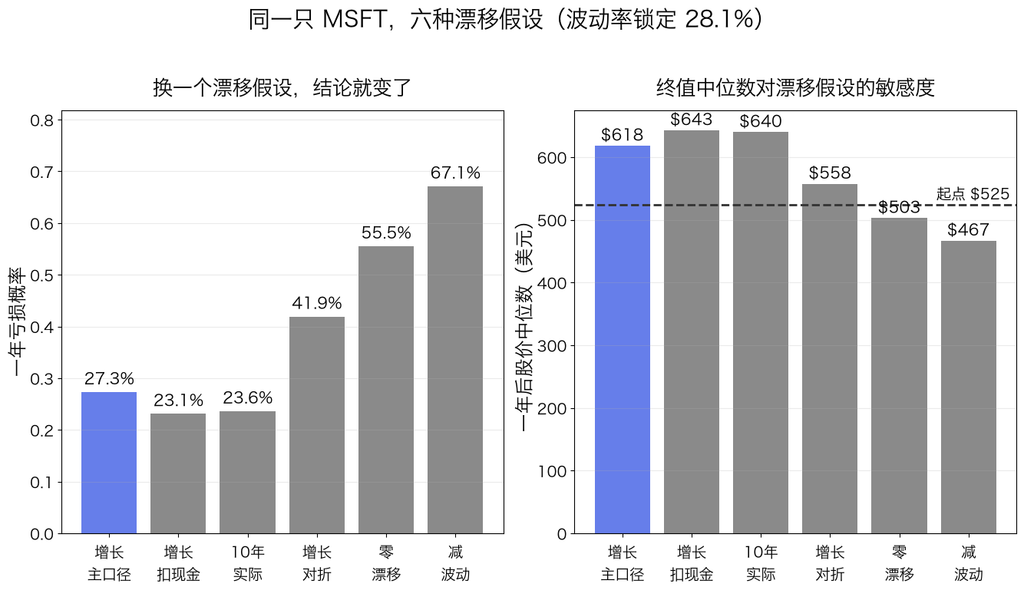
差异的实际后果就在这张图里。波动率锁死在28.10%不动,光换漂移假设,结果就差很多。
| 漂移假设 | g | 一年后中位数 | 亏损概率 |
|---|---|---|---|
| 基本面增长(不扣现金) | 20.67% | 618.32 | 27.30% |
| 基本面增长(扣现金+短投) | 24.58% | 642.99 | 23.10% |
| 近10年实际几何年化 | 24.11% | 639.96 | 23.60% |
| 基本面增长打对折 | 10.33% | 557.62 | 41.90% |
| 零漂移 | 0% | 502.87 | 55.50% |
| 增长减波动率 | -7.43% | 466.86 | 67.10% |
同一个模型,同一只股票,只是漂移换了个算法,亏损概率从27.3%一路跑到67.1%。而这个漂移是整个模型最脆弱的一环,它靠的是某一天财报里的那几个数字。
基本面增长打对折这一档,我一开始觉得是在刁难人,后来发现它最有道理。公司不会永远以20%的速度增长,这个速度撑不了几年。
三、拿真实历史校准一遍
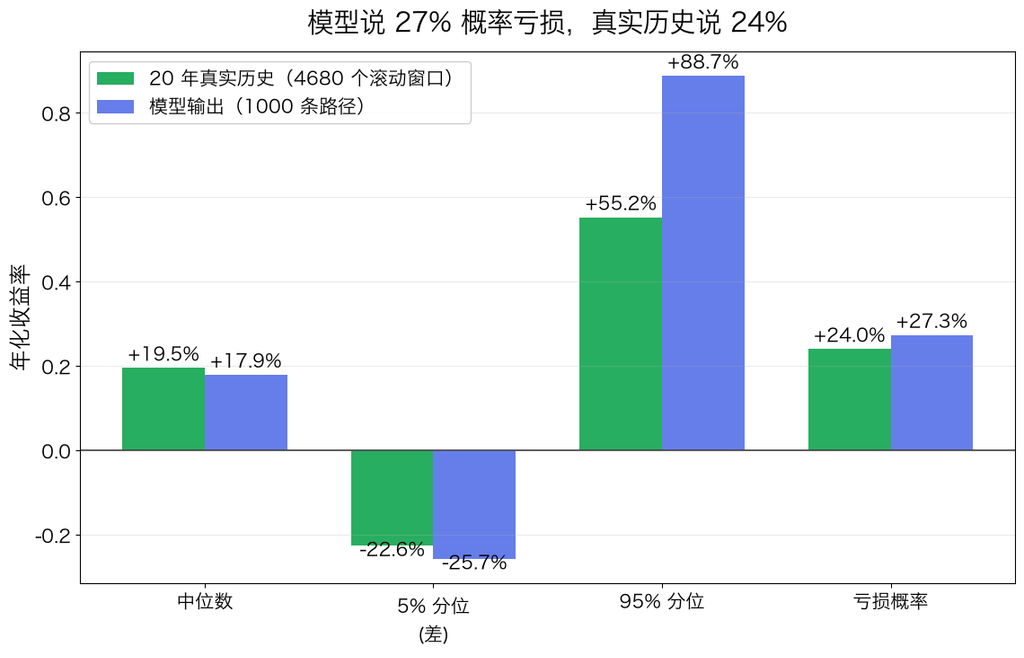
模型再漂亮,也得跟现实对一下。我拿微软过去20年4932个交易日,切出全部4680个重叠的252日窗口。看真实的一年期收益到底长什么样。
| 指标 | 20年真实历史 | 模型输出 | 差值 |
|---|---|---|---|
| 中位数 | 19.50% | 17.89% | +1.62 个点 |
| 5% 分位 | -22.61% | -25.72% | +3.11 个点 |
| 95% 分位 | 55.22% | 88.74% | -33.52 个点 |
| 亏损占比 | 23.97% | 27.30% | -3.33 个点 |
亏损概率这栏,模型说27.30%,真实是23.97%,模型偏悲观3.33个点。这个差距我能接受。
95%分位那栏差得远。模型说最好能涨88.74%,真实最好的年份才55.22%。这说明一件事:几何布朗运动对右尾是系统性高估的。它假设涨跌的概率分布左右对称,可真实股票不是这样。牛市那几年能把右尾拉得很长,模拟的随机游走拉不出来。
四、模型漏掉的,是最疼的一段
先看好的一面。模拟里1000条路径的年内最大回撤,中位数是-21.68%。这个数字看着挺温和。可真实情况,微软近10年最深的一次回撤是-37.56%。
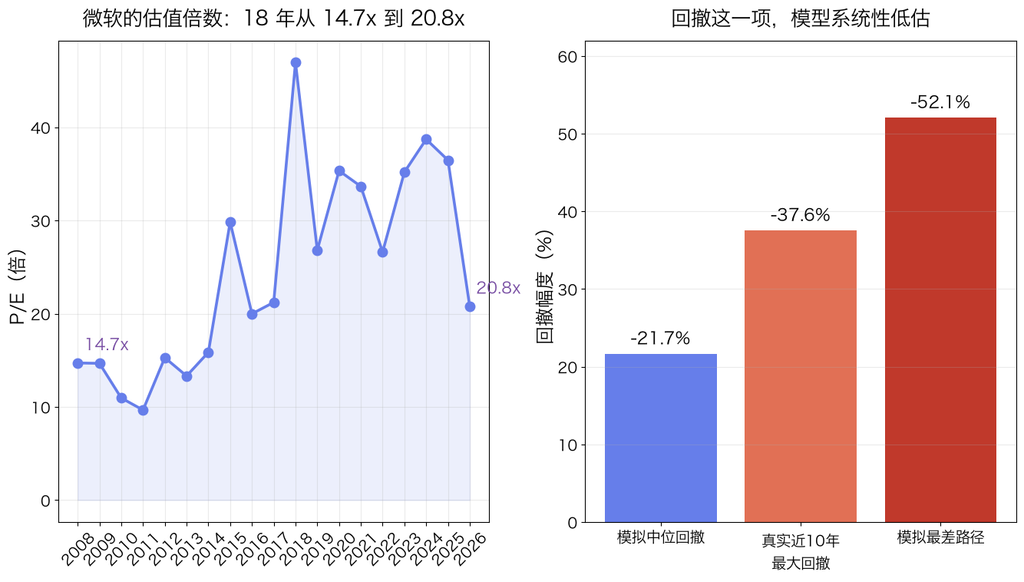
中间那根是模拟的中位回撤。右边那根是最差的一条路径,年内回撤-52.08%。左边那根是真实历史,-37.56%。
差了15.9个百分点。这不是精度问题,是方向性问题。这个数我反复核了两遍,怕是回撤窗口取错了。
原因在于几何布朗运动假设每一步都互不影响,涨一步跌一步各算各的。真实市场不是这样,回撤是连着来的,恐慌会连着恐慌。真遇上2008年或者2020年3月那种行情,模型给你的数字根本救不了你。
我还测了另两个容易被忽略的地方。一是换随机种子,用5个不同的种子各跑一遍。5%分位在384.53到392.78美元之间跳,亏损概率在25.70%到28.60%之间跳。报出来的那个28.1%,落在区间的偏上位置。
二是换路径数量,100条时5%分位是373.31美元,20000条是390.67美元,样本少的时候尾部那几个数字就飘。用1000条,这个量勉强够用,但要知道它一直在飘。
五、真正决定股价的,其实是倍数
模型里完全没提估值倍数。我核对数据的时候把整个流程翻了一遍,才确认这不是漏写,是真的没做。这是整个模型最大的缺口。
股价涨幅可以拆成两截,一截是盈利涨多少,另一截是倍数变多少。微软18年的实际数据里,EPS年化涨13.39%,股价年化涨15.59%。剩下的1.94%来自倍数从14.7倍变成20.8倍。
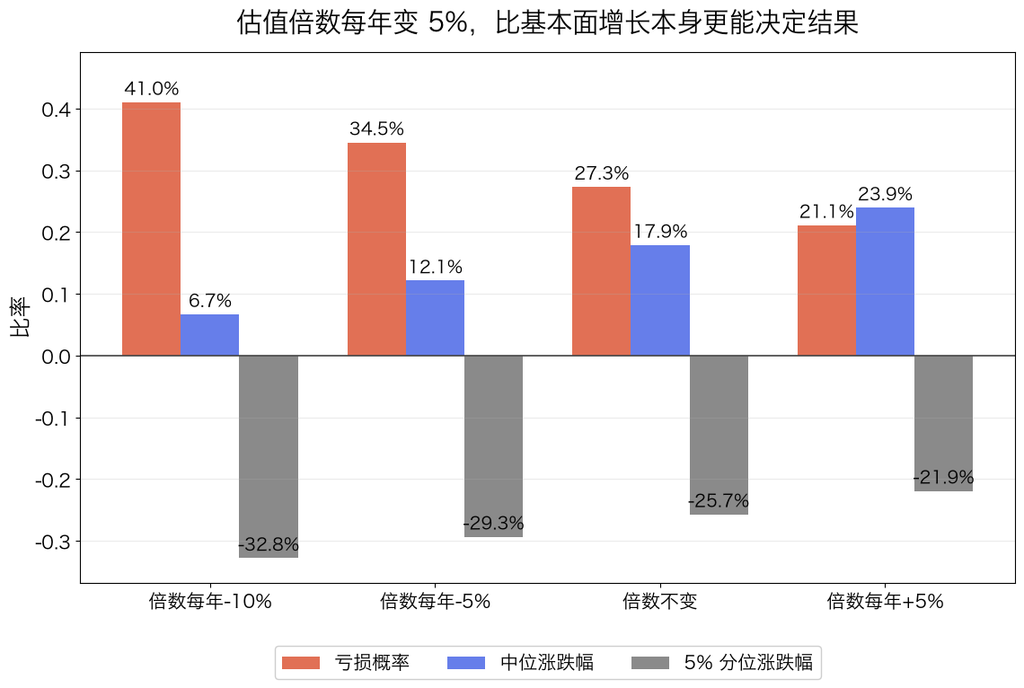
倍数这1.94%的年化,在模型里是零。而它完全可以是负的。我把倍数漂移加进模型再跑一遍,结果如下。
| 倍数每年变动 | 一年后中位数 | 亏损概率 |
|---|---|---|
| -10% | 559.48 | 41.00% |
| -5% | 588.16 | 34.50% |
| 0 | 618.32 | 27.30% |
| +5% | 650.02 | 21.10% |
倍数每年压缩5%,亏损概率从27.3%跳到34.5%,比基本面增长打对折的影响还接近。而一个模型算出来的27%概率亏损,前提是市场愿意继续按今天的估值给这家公司定价。这个前提很脆弱,比公司能维持20%增长还脆弱。
六、同一套代码换到A股
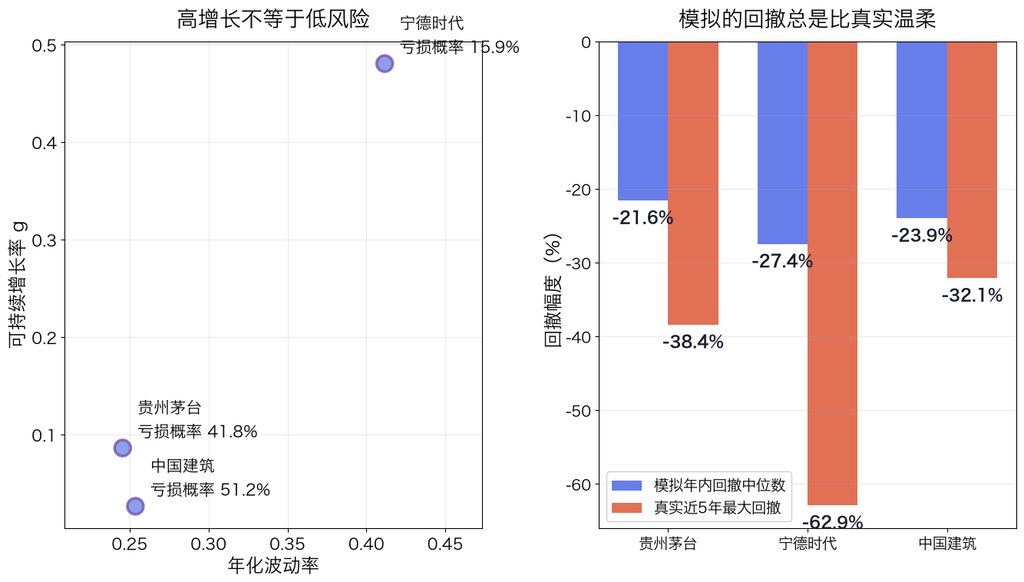
美股的数据毕竟隔着一层。我把这套代码搬到A股跑了一遍。标的选了贵州茅台、宁德时代、中国建筑。财务口径用TTM,就是最近12个月的累计数,不是单季。
| 标的 | ROIC | g | 波动率 | 亏损概率 | 模拟回撤中位 | 真实近5年最大回撤 |
|---|---|---|---|---|---|---|
| 贵州茅台 | 42.66% | 8.62% | 24.55% | 41.80% | -21.55% | -38.38% |
| 宁德时代 | 59.72% | 48.05% | 41.15% | 15.90% | -27.44% | -62.88% |
| 中国建筑 | 4.09% | 2.64% | 25.36% | 51.20% | -23.95% | -32.07% |
宁德时代这一行最反直觉。g高达48.05%,是三只里最高的。可亏损概率只有15.90%,全场最低。我盯着这一行看了两遍,确认不是脚本排错了。中国建筑g只有2.64%,亏损概率51.20%,接近一半。
原因在波动率那一列。宁德时代41.15%的波动足以吃掉它的增长优势,中国建筑25.36%的波动率配2.64%的增长,基本没有安全垫。
这就是这个模型最值得带走的一点。增长决定上限,波动率决定你能不能拿到那个上限。
回撤那一栏还是老问题,三只都是模拟比实际温和。宁德时代模拟-27.44%,真实跌过-62.88%,差了一倍多。
七、动手部分的代码
模型本身很短,四十来行。下面是我用的核心部分。
先算增长率。下面这段用扣现金的口径,算出来是24.58%,对应第三节表格的第二行。想复现主口径那20.67%,把 invested_capital 里的 cash_and_sti 去掉就行。
nopat = operating_income * (1 - tax_rate)
invested_capital = equity + debt - cash_and_sti
roic = nopat / invested_capital
retention = 1 - dividends_per_share / eps
g = retention * roic
再算波动率,然后跑路径。
import pandas as pd

window = prices.tail(1255)          # prices 是 pandas Series
daily_log = np.log(window).diff().dropna()
sigma = daily_log.std(ddof=1) * np.sqrt(252)

dt = 1.0 / 252
drift = (g - 0.5 * sigma ** 2) * dt
diffusion = sigma * np.sqrt(dt)
z = np.random.default_rng(42).standard_normal((1000, 252))
paths = price * np.exp(np.cumsum(drift + diffusion * z, axis=1))
算路径上的最大回撤。
running_max = np.maximum.accumulate(paths, axis=1)
drawdown = paths / running_max - 1.0
max_dd = drawdown.min(axis=1)
八、这套方法该怎么用
说说我自己的判断。它适合干一件事,把明年会怎样这种没头没脑的问题,换成一个有形状的分布。看到27%这个数字,你就知道最坏情况大概在400美元附近,最好在990美元附近,中位数在620美元。这个信息比「大概率会涨」有用得多。
它不适合干的是拿它决定仓位。光是回撤被低估16个点这一条,就足以让一个靠它做风控的人在下一次危机里被打穿。
还有一件必须交代的事。模型的漂移来自某一天的财报。微软是2026年6月30日财年数据,股价是10月23日的524.51美元,这中间涨了40%。现在换个日期重跑,起点变了,所有数字都变。基本面是慢变量,股价是快变量。拼在一起的时候,得记得它们不是同一个时间尺度。
说不好这套方法放到别的票上还成不成立。波动率35%的高成长股和波动率20%的低波动股,回撤的分布形状完全不一样。这个模型算不出这个差别。
最后是那个必须做的一致性检查。模拟输出一堆漂亮数字之后,拿20年真实历史算一遍同样的统计量,摆在一起看。差3个点能接受,差16个点就该回头查代码。
建议大家挑一只自己持有的票,用同样的流程跑一遍,再拿它的真实历史校准一次,跑完就能看到模型给的概率和现实差多少。
结尾
模型给的是一个分布,不是一个答案。它告诉你的是概率,不是承诺。我更倾向把它当成一把尺子,不是水晶球。
你的模型里,那27%的亏损概率,是按什么口径算出来的?
觉得有用的话,把这篇转给同样在搞量化的朋友。
参考资料
– SEC EDGAR XBRL companyfacts, Microsoft Corporation (CIK 0000789019),接口 https://data.sec.gov/api/xbrl/companyfacts/CIK0000789019.json – akshare stock_us_daily,新浪财经美股日线接口 – Lo, S.-Y. (2001), Euler-Maruyama Method, Scholarpedia
#蒙特卡洛模拟 #EulerMaruyama #量化模型 #ROIC #可持续增长率 #随机过程 #美股 #A股量化 #风险评估 #估值模型 #量化开发 #数据分析
Be First to Comment