作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。
模型评测不等于投资建议。
不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3100 字 | 预计阅读 10 分钟,后有代码和项目地址,建议先收藏
先说清楚这个项目有多大。这条我特意查了两遍,怕是自己记错了。60 这个数第一眼看到的时候我是不太信的。
60 star,21 fork,MIT 协议,2026 年 7 月 25 日创建。开源 issue 0 个。
按体量看,这是个没人注意的小项目。
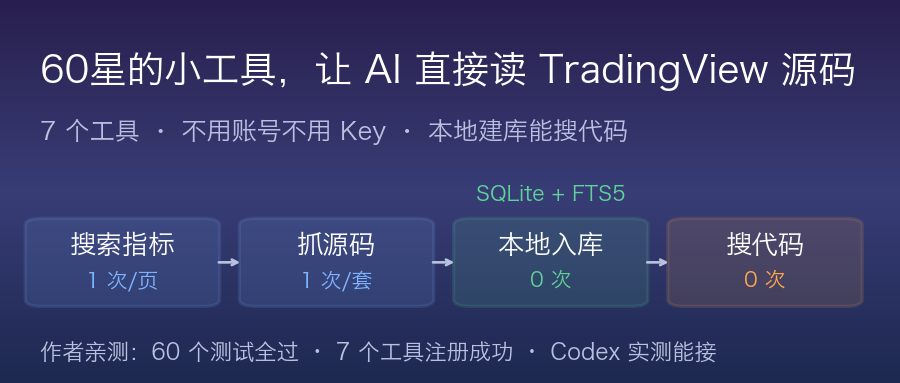
但它做的事有点意思。把 TradingView 上那几十万套公开指标和策略,变成 AI Agent 能直接查询的结构化接口。7 个工具,不需要 TradingView 账号,不需要 API Key,不需要 cookie。
我花了点时间把它拉下来、装起来、把协议层和检索层都跑通了。
先给我的测试结论。工程这一半做得很扎实,数据这一半要泼点冷水。说不好的人不用勉强自己用,我个人更倾向把它当成一个研究工具。
它到底做了什么
项目叫 tradingview-indicator-search-mcp-server,作者是 daviddme。这个项目就是让 AI 直接研究 Pine Script 源码。
TradingView 上有海量社区脚本,多数是开源的。这个 MCP 把它们变成工具箱里的 7 个函数。
我实测列出来的工具是这样的。
| 工具 | 干什么 |
|---|---|
search_scripts | 按主题搜,比如「趋势跟随」「剥头皮」 |
list_editors_picks | TradingView 编辑精选 |
list_author_scripts | 搜某个作者的全部公开作品 |
get_script_source | 拿一套脚本的完整 Pine 源码 |
harvest_scripts | 批量采集入库,可断点续传 |
query_corpus | 搜本地库,能搜到源码里的代码 token |
fetch_status | 看限速状态和库存量,不发网络请求 |
最后一个 query_corpus 是这个项目真正的价值所在。
TradingView 网站上搜「supertrend」,你只能搜到指标的名字和描述。但本地库里能直接搜 ta.supertrend 这个字符串——找到所有真正调用了这个函数的策略。
README 里那句「The TradingView website cannot do that」,说得没错。
实测,MCP 协议这一层完全跑通
我先做的第一件事,是直接跟它说话。说实话第一次握手我以为会失败,毕竟这种自建 MCP 常常参数结构对不上。我当时还想,真不行就自己写一个 mock。
用 MCP 协议握手,服务器自报名字 indicator_fetch,版本 1.0.0,协议版本 2024-11-05。能力声明只有一项,tools 里的 listChanged 为真,意思是工具列表变了会通知客户端。
7 个工具全部注册成功,参数结构完整。
然后调 fetch_status,返回的 JSON 里限速器状态、每日预算、本地库存量一应俱全。再调 query_corpus,也能正常响应。
项目的 60 个测试也全过,3 个测试文件,跑 2.91 秒。测试全是离线的,用真实抓取的 API 响应喂解析器,还给限速器注入了假时钟,所以测试本身不会真的去等。
三个搜索面的数据差距,比我预想的大
这是我这篇最想讲的东西。
项目里带了四份真实抓取的 TradingView 响应,我全解析了一遍。同一天、同一页位置、同样的 24 条,差别很大。
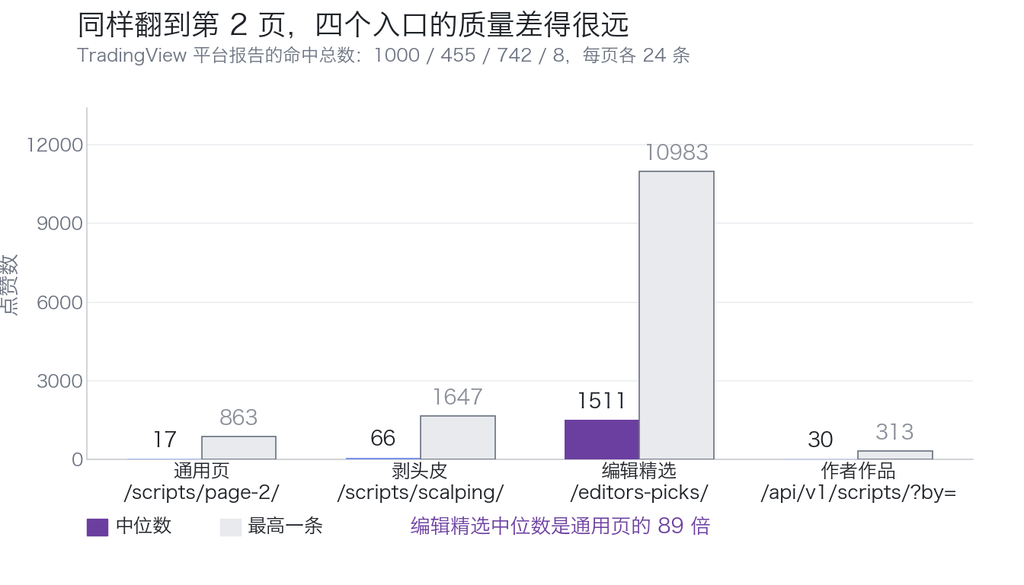
通用页 /scripts/page-2/,平台报告命中总数 1000,24 条里点赞数中位数 17。
剥头皮页 455 条,中位数 66。
编辑精选 742 条,中位数 1511。
编辑精选的点赞中位数是通用页的 89 倍。最高那条 10983 赞,最低 172 赞。而通用页最低才 10 赞。
这个差距有实际含义。我估计选错入口的人占大多数。通用页排出来的前 24 条,很可能只是最近更新的,不是最好的。作者要拿到编辑精选这一档,得先被人翻过一遍。
89 倍这个数我盯着看了一会儿。同一页、同一天、同样 24 条,差别全在入口选得对不对。我第一反应是数据抓错了,回头核了三遍才敢信。
所以「按主题搜索」这个功能,用哪个搜索面,出来的结果质量差着一个量级。
还有一组数我盯着看了好一会儿。四份样本一共 80 条,脚本类型是策略的只有 3 条,指标 77 条。
TradingView 上「指标」和「策略」是两个东西。指标画线画箭头,策略能下单能算绩效。
这个 MCP 的能力描述里,「search indicators and strategies」并列着写。但从真实数据看,搜出来的东西压倒性是指标。
采集不是瞬间完成的,要按小时算
让 Claude 收集 100 套趋势策略听起来很美。我把 README 的限速参数拿来算了一下实际开销。
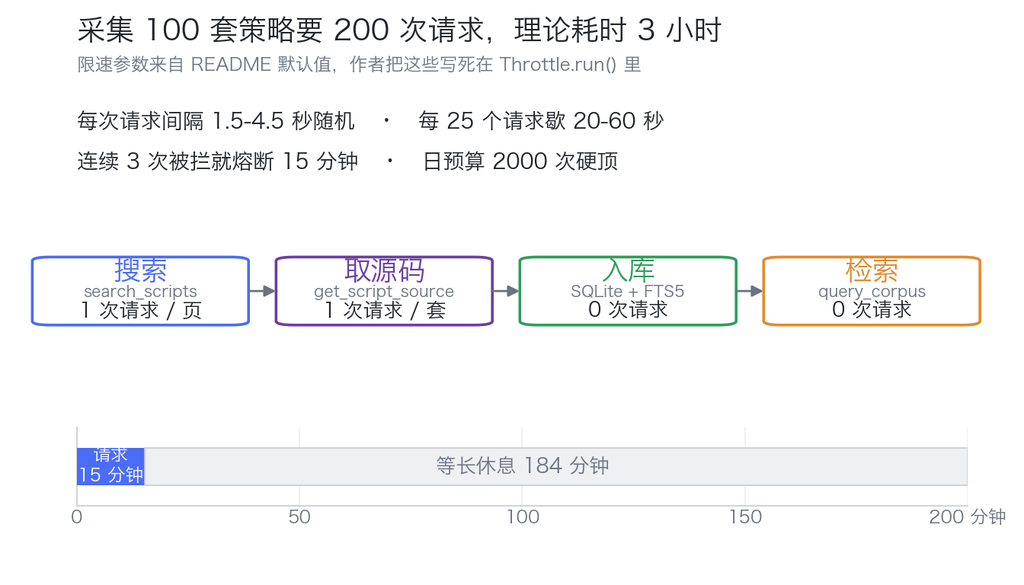
每次请求间隔 1.5 到 4.5 秒随机,平均 3 秒。每 25 个请求来一次长休息,20 到 60 秒,平均 40 秒。
采一套脚本要两次请求,一次拿列表,一次拿源码。
| 采集量 | 请求数 | 理论耗时 | 占日预算 |
|---|---|---|---|
| 100 套 | 200 | 15 分钟 | 10% |
| 200 套 | 400 | 31 分钟 | 20% |
| 500 套 | 1000 | 77 分钟 | 50% |
| 1000 套 | 2000 | 153 分钟 | 100% |
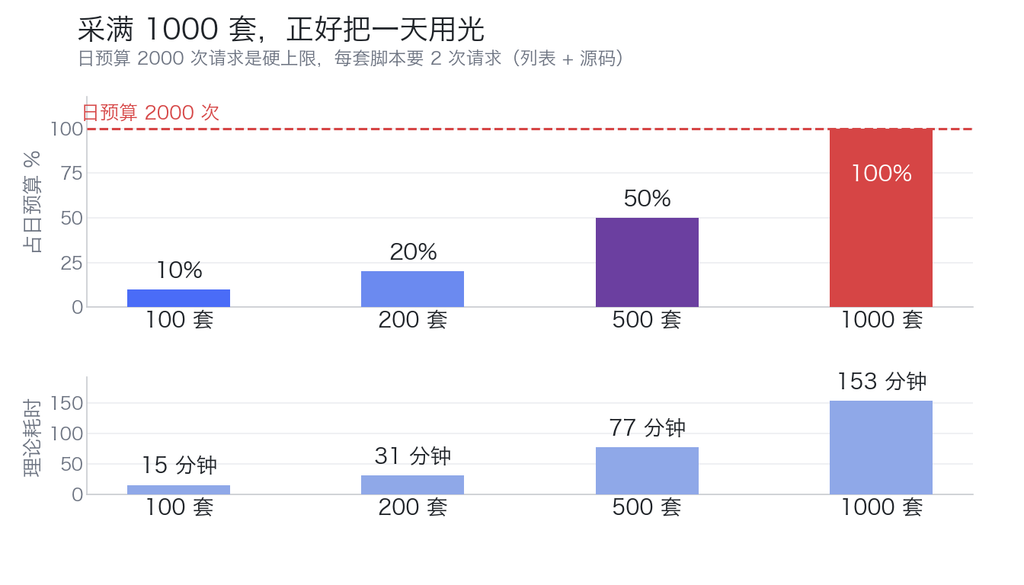
日预算 2000 次请求,是硬上限。采满 1000 套正好把一天用光。
如果只采列表不采源码,100 套只要 5 分钟。
这几分钟不是缺陷,是设计。搞懂这一点之后我就不想再吐槽它慢了。TradingView 会封禁刷取行为,这套限速器的逻辑是:严格串行、随机间隔、每 25 个请求歇一次、连续三次被拦就熔断 15 分钟、每日 2000 次硬顶。
代码我看过了,Throttle.run() 是所有出网请求的唯一入口,没有工具能绕过它。README 里那句「The single most important safeguard here」,指的是熔断器。
这有点讽刺。这套防封禁设计得越好,你想大规模扒源码就越慢。
上下文成本这一块,作者算得很细
MCP 工具最怕的一件事,返回一大堆内容把 Agent 上下文塞爆。
这个项目对 listing 做了裁剪。单条 listing 只保留必要字段,描述截断到 300 字符。
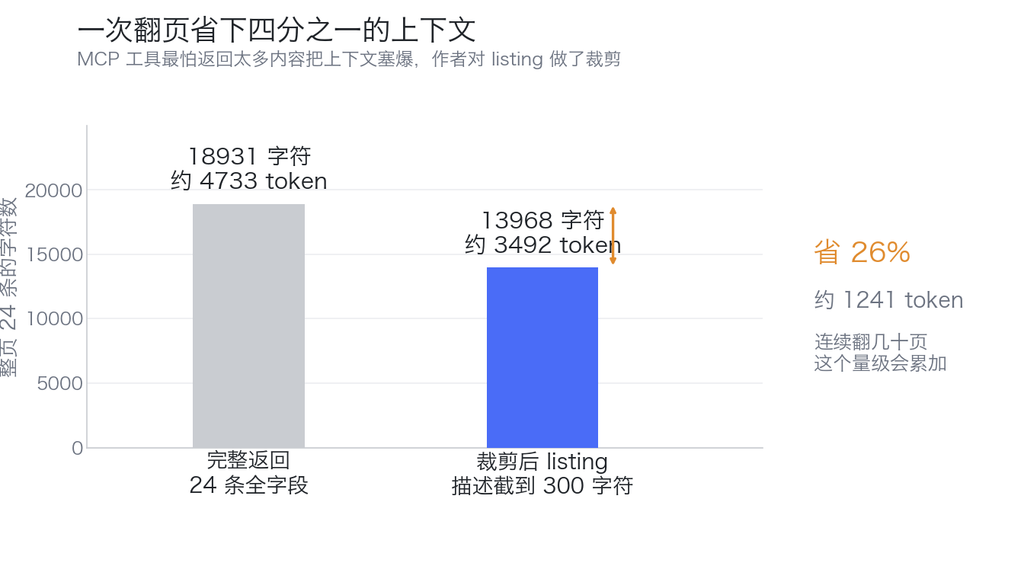
我实测了一下。整页 24 条,裁剪后 13968 字符,约 3492 token。不裁剪是 18931 字符,约 4733 token。
省掉 26%。
对于要连续翻几十页的场景,这个节省是实的。
一个容易被忽略的设计,它绕开了 TradingView 的 JSON API
这是我在源码里看到的第二个值得说的地方。
TradingView 有两个搜索接口。一个是 slug 路由,/scripts/trend-following/ 这样的页面地址。另一个是 JSON API,/api/v1/scripts/?q=trend+following。
作者选了前者。
README 里写了原因,用的词是「Poor relevance」。他实测过一次 JSON API 搜 trend+following,排名第一的结果是「Split Volume + Signals」,跟趋势跟随没什么关系。
而 slug 路由返回的是编辑人工整理过的主题页,真正切题。
JSON API 不是不能用,它有一个长处,作者也用上了。按作者名搜索。/api/v1/scripts/?by= 这个是 JSON API 做得最好的部分,作者作品那一类就走这条路。
还有一处细节挺妙。TradingView 的 API 每次响应里都会自报查询参数表,在 data.ideas.params 那个位置。script_type 有 indicators、strategies、libraries、all 四个可选值,script_access 有 open 和 all,sort 有 latest_popular 和 recent_extended。
等于说平台把自己的查询语法写在响应里了,作者直接读出来用。这种设计我还挺喜欢的,省得猜。
我在 fixtures 里验证过这个结构,data.ideas.data 下面确实是 total、items、next 三个字段,total 就是平台报告的命中总数。
本地库能搜什么,网站搜不了什么
这才是这个项目和在 TradingView 上手动翻的根本区别。
TradingView 的搜索框搜的是名称和描述。你输入 supertrend,返回 25 条匹配的名字和简介(我实测过这个数)。
但你想找的是哪几套策略真的调用了 ta.supertrend 这个函数。这个问题在 TradingView 网站上没法问。
本地库的做法是双检索。FTS5 全文索引建在 name、author、description、source 四列上,搜名称作者描述走它。而搜源码里的代码 token 走另一条路,是 LIKE 子串匹配。
为什么要分成两条路?README 里解释得很清楚。FTS5 的分词器会把 ta.supertrend 拆成 ta 和 supertrend 两个 token,搜不精确。代码 token 必须用字面子串匹配。
我本地试了一遍 source_contains="strategy.entry" 和 source_contains="ta.supertrend",都是 0 条。原因是我这台机器上只有 1 份合成源码样本,不是这个功能坏了,机制在项目的集成测试里有覆盖。
表结构是 5 张表加 1 个 FTS5 虚拟表。scripts 存元数据,sources 存源码和版本号,searches 存列表缓存,harvests 存采集进度(这就是断点续传的实现),request_log 存每个请求的日志(限速器和预算都从这里算)。
缓存这一层设计得很细。Pine 源码按版本是不可变的,所以缓存命中就永远不会再请求源。这一条比其他所有优化加起来省得多。我看到这里停了两秒,这个判断挺准的。
三件必须说清楚的事
第一点,README 里没有提 Codex,但是可以用。
我把整个仓库扫了一遍,Codex 出现 0 次。README 的安装章节只写了 Claude Code、Claude Desktop、Cursor 三个,后面加一句「Any MCP-compatible client works」,括号里列了 Windsurf、Cline、Zed。
但本机装了 Codex,我实测了一下。
codex mcp add tradingview -- node .../src/server.js,返回 Added global MCP server 'tradingview'。codex mcp list 显示状态 enabled。codex mcp get 显示 transport 是 stdio。
所以技术上完全能接,只是作者没写。你按 Codex 的 TOML 语法手写一段就行。
第二,版权这件事作者交代得很清楚。
NOTICE.md 里有一节专门讲第三方内容,原话是「Pine Script you collect is not yours」。TradingView 上公开可读的脚本,版权仍属原作者。采集来的源码只授权你阅读、学习和在作者许可范围内改编,发布衍生作品要署名。
这个工具不给你任何授权。
第三,npm install 会报 14 个漏洞。
3 个 critical,5 个 high,6 个 moderate。我逐个查了来源,全部在 devDependencies 的 vitest 及其依赖链里(tinypool 的原型污染、proxy-addr 的 IP 欺骗、vite 的路径穿越)。运行时只依赖两个包,@modelcontextprotocol/sdk 和 zod。
那个 high 是 MCP SDK 本身的 OAuth 凭据外泄问题。这个服务器不用 OAuth,所以不影响实际使用。
最后
这个项目最让我认的不是它有 7 个工具,是它对边界的处理。老实讲,一个 60 星的项目能把这事讲明白,挺少见的。
限速器是硬编码在最低层的,没有工具能绕过。熔断器触发后会明确告诉你「用 query_corpus 离线干活」。NOTICE.md 里主动写清楚源码版权不归你。README 里写「最好在家用宽带跑,别放云上,因为机房 IP 更容易被封」。
一个 60 星的工具,把这些都写在前面,而不是等用户踩坑。说实话这份自觉比 7 个工具本身更值钱。
它解决的问题也具体:以前要在 TradingView 上翻来翻去找指标,现在可以让 Agent 先批量拉一批回来,再按源码里的代码特征筛。
指标搜索 → 源码采集 → 本地检索 → AI 辅助研究,这条链路的每一环它都串起来了。
那它到底适合谁?我想了一下,觉得有两点要注意。
Python 那套量化工具解决不了「TradingView 上那些策略长什么样」这个问题,它解决的是另一个问题。Codex 能接但文档没写,得自己配。
建议大家可以先跑一次 npm test,60 个测试 3 秒跑完,全离线不碰网络,先看看它的解析逻辑写得多干净。
参考资料
- 项目仓库 https://github.com/daviddme/tradingview-indicator-search-mcp-server
- 版权与合规声明
NOTICE.md - 离线测试样本
test/fixtures/ - 限速器实现
src/throttle.js - 本地库与全文检索
src/db.js - 本篇复现脚本
outputs/tradingview-pine-mcp-search/repro_tv_mcp.mjs - 复现数据
outputs/tradingview-pine-mcp-search/repro_data/
#TradingView #PineScript #MCP #开源量化 #AI工具实测 #ClaudeCode #Codex #量化平权 #GitHub开源
Be First to Comment