作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
文中示例仅用于技术讨论,不构成任何操作建议。
量化策略开发应以学习和技术交流为目的。
本号不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3050 字 | 预计阅读 8 分钟。
先看一场PK。
一边是 SearchCast,一篇把线性回归调到极致的论文。另一边是 Datadog 的 Toto-2,一个零样本(zero-shot)时序基础模型。
零样本翻译成大白话,就是下载权重,喂数据,读结果,中间一步训练都没有。
比分 5 胜 1 平 0 负。赢的是零样本这边。
我原本以为这标题是标题党。翻完代码和结果表,我想说的还得再说一遍。
比分之外有两样更值钱的东西。一样是省算力的抽窗法,一样是一处引用口径的猫腻。
| 数据集 | Toto-2 | SearchCast | 差值 |
|---|---|---|---|
| ETTh1 | 0.375 | 0.403 | -0.029 |
| ETTh2 | 0.332 | 0.332 | 平 |
| ETTm1 | 0.331 | 0.346 | -0.015 |
| ETTm2 | 0.237 | 0.240 | -0.003 |
| Exchange | 0.330 | 0.343 | -0.013 |
| Weather | 0.213 | 0.215 | -0.002 |
数字是归一化 MSE,越低越好。两边在完全相同的测试窗口上算分。赢得干净的有 3 个,ETTh1、ETTm1、Exchange。另外 2 个赢在噪音范围内,ETTh2 打平。
差距不算碾压,最大的一处只有 0.029。但两边的前提差得远。SearchCast 在每个数据集上单独搜参,六场比武各穿一件定制盔甲。Toto-2 权重固定,从没见过这些数据,称完重直接上场。
看到这儿我停了一下。不是因为它反常识,是因为这场景我熟。
电网调度、云主机扩容、电商备货,背后全是时序预报在扛。模型选错一层,多烧的都是真金白银。这场对决把一个老问题重新摆上台面,简单的模型和庞大的模型,到底该怎么选。
一、SearchCast 是什么
SearchCast 拆开看其实很朴素。
它的基本单元是 Ridge 回归,一种带正则化的线性回归,有闭式解。训练不走梯度,没有反向传播这一说。
我盯着它的架构图看了半天,越看越简单。通道独立,每条序列各算各的。要往前推的 720 步不一口气做完,切成 15 片,每片 48 步,一片一个小模型。每个数据集还要单独搜参,历史窗口多长,正则加多重,一个个试,谁的成绩好用谁。
最让我意外的是它没装的东西。没有季节项,没有差分,没有日历特征。经典时序模型赖以生存的手工零件,一个都没有。就是最裸的过去值映射未来值。
就这。它还在六个公开基准上跟调满配置的 Transformer 打得有来有回。
这种事我自己也栽过。之前测过一套多模型赛跑的方案,六个花哨模型一起上,最后经常跑赢的反而是最朴素的那个。当时我是有点想不通的。同样的道理,SearchCast 干脆做到了极致,全用线性,把功夫全花在搜参上。
一堆线性回归逼平 Transformer。这件事值得整个领域想一阵子。
二、Toto-2 是什么
Toto-2 是 Datadog 出的时序基础模型。GIFT-Eval 榜单上排在基础模型第一梯队。
它跟 SearchCast 是两个物种。SearchCast 换一个数据集,就要重搜一轮参数。Toto-2 什么都不搜,权重出厂那天就固定了,数据来了直接出结果。它还是原生多变量,通道之间信息天然互通。这个特点后面会变成胜负手。
读完这段我第一反应是,这不公平。
这场评测里,它跑在 CPU 上,float32 精度,官方发布版原样加载。没有微调,没有为任何数据集单独开过的开关。
三、一场公平的PK
比武最怕规则偏心。
这场评测的方法论我拆了一遍,三个细节我当场抄了下来。
第一,配对比较。两个模型在完全相同的测试窗口上算分。窗口对窗口,误差对误差,谁也挑不到更好算的窗口。
第二,均值不是中位数。这个坑最隐蔽。Toto-2 输出的是一串分位数,中位数是它的默认点位。坑就在这。中位数让 MAE 最小,这套基准算的是 MSE,让 MSE 最小的是均值。评测者从分位数分布里把均值估了出来。细节看着偏门,用错了整场对比直接作废。
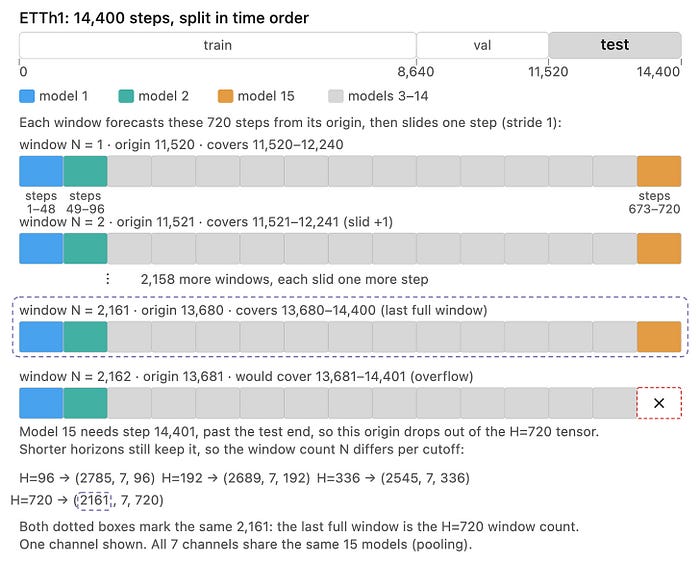
第三,256 个窗口省下几天算力。这个最实在。预报长度 720 步的设定下,ETTh1 的测试段要滚出 2161 个窗口。全量扫一遍,2.5B 的多变量模型在一个数据集上就要跑 14 个小时。六个数据集跑完,按天计。评测者先验证了一件事,均匀抽 256 个窗口,算出的平均误差与全量的差距,落在噪音底以下。几天的算力缩成一个下午,答案不变。
四、PatchTST 的数字有水分
论文里最提气的结论,是线性模型把最强 Transformer 基线 PatchTST 甩开一大截。
我把基线出处一个个核对过去,翻到这张表的时候,人是懵的。这页不干净。
论文声称非线性基线引用自各家原始文献。三个大数据集确实如此。Weather、Electricity、Traffic 用的是 PatchTST 自己发表的成绩,回看窗口 512,完整实力。四个 ETT 数据集填的却是回看 96 的弱版本,数字来自后来论文的转述。两个版本的 PatchTST 坐在同一列里,读表的人看不出来。
一样的列名,一样的表格格式,两个回看窗口不同的模型并排坐着。扫一眼是看不出差别的。
我核对完又回头看了一遍,确认不是我看错。
把完整成绩换回去,局面就变了。SearchCast 在 ETT 上的领先,从大幅甩开缩到 0.007 与 0.019 之间。ETTh2 和 Traffic 两行,被 PatchTST 直接反超。
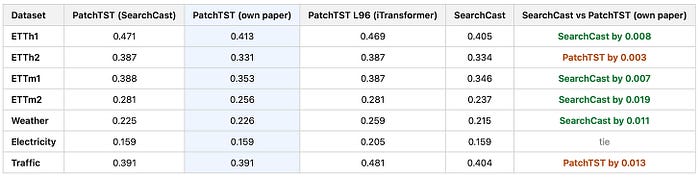
判定还挺公道。这不像是故意美化。强者的完整数字,恰好用在强者打平或赢下的数据集上,更像收集基线时的口径混乱。无心之失,但影响实打实。线性模型吊打 Transformer 的画面,一多半是借来的弱数字画出来的。
这页值得每个做研究的人记一笔。基线数字从哪来,用什么配置跑出来,这个问题翻车起来悄无声息。顺手就可以自查,手头对照实验里的基线列,你真的知道它是拿什么配置跑出来的吗。
五、通道一多,画风就变
Electricity 有 321 条通道,Traffic 有 862 条,是六个数据集里最大的两个。也恰好是 SearchCast 对 Transformer 战绩最差的两个。一个打平,一个输。
这个巧合我一开始没想通,去查了才明白。
通道之间高度相关通道之间高度相关,谁能跨通道共享信息,谁就占便宜。SearchCast 通道独立,天然吃亏。
Toto-2 的多变量是娘胎里带的。受内存限制,评测者只跑动了最小的 22m 版本。就这样,Electricity 上已经领先,0.1578 对 0.1593。Traffic 上基本追平,0.4051 对 0.404。
注意,这两块是 SearchCast 自己最强的地盘。它在自己的强项上,被一个不训练的模型追平了。
更大的版本还没上场,这笔账得留着。
六、我们能学的三点
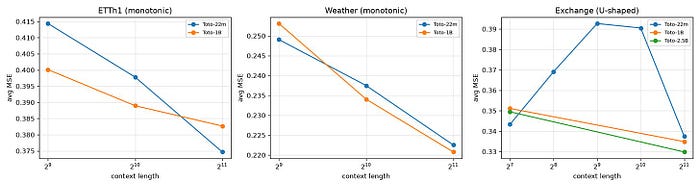
第一,上下文默认给长。Toto-2 的误差随历史窗口拉长往下走,一路测到 2048 步。例外也明确。稀疏序列上,长窗口灌进来的多是空白,反而稀释近期信号。1000 步以内的短窗口经常更好。默认长,数据稀就短。
第二,强基线永远是第一道题。SearchCast 输了,但它作为基线的价值一点没掉。一堆 Ridge 回归,就能跟精调 Transformer 掰手腕。以后见到任何新模型,我先让它跟这种级别的基线过一招。过不了,我会先怀疑自己的评测。
第三,零样本的比分别直接搬进金融市场。电力、天气这类数据规律性强,信噪比高。金融时序的信噪比低得多,零样本优势能不能在行情数据上复制,这份评测没给答案。真正通用的是方法论那一层。配对窗口,均值与中位数的取舍,抽窗验证,基线口径核对。这套纪律放在哪个数据上都成立。 这一条我自己是有切身的体会。行情数据的涨跌基准率常年贴着五五开,任何模型在金融数据上挤出来的超额,往往就零点几个百分点,一个窗口抽歪了都能把它抹掉。零点几个百分点,我见过太多次了。所以在金融数据面前,这套评测方法比评测结论更值钱。
这场对决看完,最值钱的启发是先跑强基线又被证明灵了一次。一堆线性回归先把注意力拉回基线,然后一个不训练的模型又提醒了所有人天外有天。
我自己的做法会更简单一点。下次拿到新模型,先花半天跟朴素基线比一比,别急着调结构。
留个问题。你手头的模型,最近一次跟 Ridge 或朴素基线正经比过一场吗?什么时候?
觉得有用的话,把这篇转给同样在搞时序建模的朋友。
#时间序列 #线性模型 #零样本模型 #时序基础模型 #Ridge回归 #模型评测 #PatchTST #Toto2 #机器学习 #量化研究 #AI工具实测 #基线对照
本文比分与表格数字来自公开评测仓库 GitHub nkafr/SearchCast(toto_M256_run)及论文 arXiv 2606.27282、2605.20119,评测时间 2026-10,本文不构成任何投资建议。
Be First to Comment