作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
文中示例仅用于技术讨论,不构成任何操作建议。
量化策略开发应以学习和技术交流为目的。
本号不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 4000 字 | 预计阅读 7-10 分钟,前半是介绍和安装,后半有完整代码,建议先收藏。
· · ·
一、这个东西是干啥用的?
GitHub 上一个叫 Sequoia-X 的开源项目,7000 星,1401 次复刻,2018 年立项,今年推倒重写成 V2。
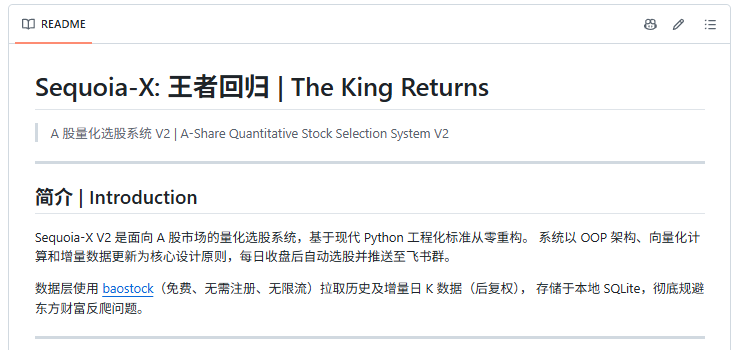
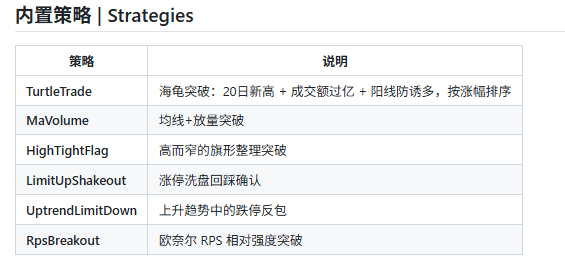
它干的活一句话能说完。A 股收盘后,自动把全市场 5000 多只股票扫一遍,谁走出了指定技术形态,挑出来,推送到你的飞书群。海龟突破、均线放量、高窄旗形、涨停回踩、趋势跌停、RPS 突破,六个策略内置,外加一个定增公告监控。
你不用装行情软件,不用趴在电脑前翻涨幅榜。每天晚上七点多,飞书机器人把当天符合条件的代码清单发到你手机上。
这类项目 GitHub 上不少,多数是半成品。这个能攒到 6954 星,我读完源码后找到三个原因。
第一,数据免费。行情用 baostock 拉,免费接口,不用注册。数据落在本地一个 SQLite 文件里,整个库能拷进 U 盘。第一次回填约 12 分钟,之后每个交易日收盘后增量更新,全市场两三分钟跑完。
第二,策略是插件。六个策略继承同一个基类,每个只实现一个 run() 方法。想加自己的策略,写一个类挂进去,主流程一行不改。
第三,推送分流。每个策略可以绑独立的飞书机器人,海龟的信号发这个群,RPS 的发那个群,互不干扰。
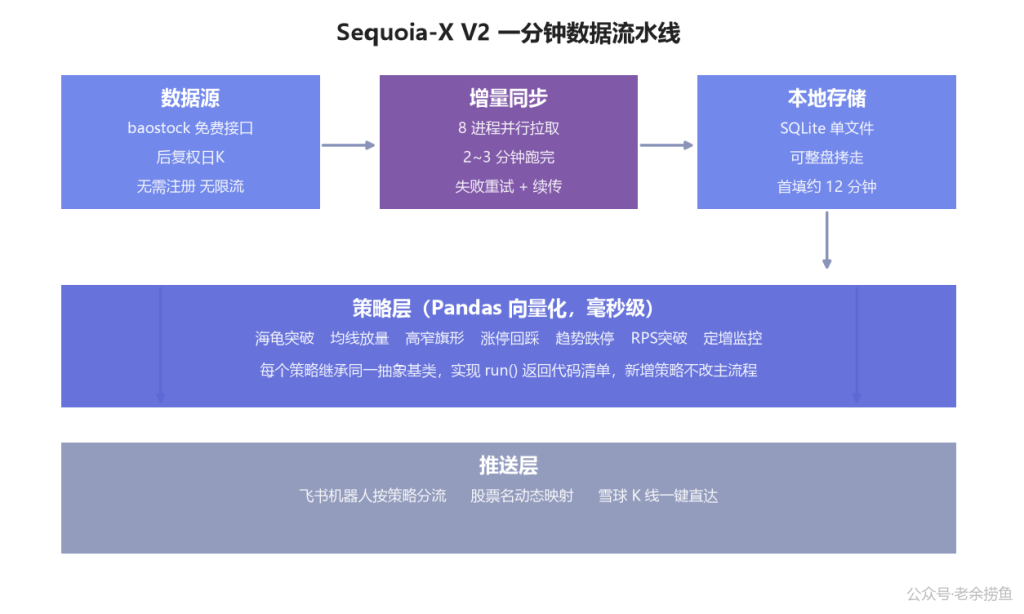
系统四层架构,数据进来,信号出去
至于它选出来的股票到底灵不灵,这是所有人第一个问题,我把答案放在下一节。
二、我测出来的结果,先给答案
先交代一句背景。项目本身没有回测模块,六个策略只判断”今天触没触发”,昨天、去年表现如何,系统不知道。所以我补了这块,把六个策略改成滚动版,在 5558 只股票、2024 年 1 月到今年 9 月的全历史后复权日 K 线上逐日重放,等于把这套系统在历史上完整跑了一遍。
两年多,一共 22 万个信号。统计每个信号之后 5 天、10 天、20 天的涨跌,和同期全市场中位数比。为什么要跟中位数比,因为市场本身有波动,水涨船高的时候随便买什么都涨,得把市场的份扣掉,剩下的才是这个形态自己的贡献。
结果一张表看清(持有 10 天口径)。
| 策略 | 10日超额 | 20日超额 | 结论 |
|---|---|---|---|
| RPS突破 | +1.69% | +2.65% | 最强,动量有效 |
| 高窄旗形 | +0.73% | +1.73% | 越拿越好 |
| 均线放量 | +0.75% | +1.30% | 稳定正超额 |
| 海龟突破 | +0.72% | +1.24% | 稳定正超额 |
| 趋势跌停 | -0.67% | +1.75% | 前十天要熬 |
| 涨停回踩 | -1.67% | -1.98% | 唯一全线负超额 |
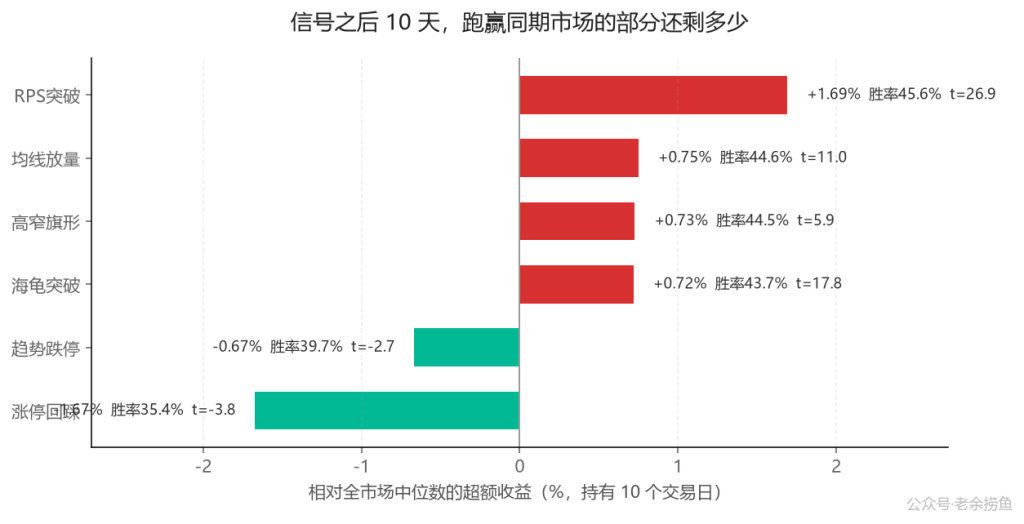
信号后 10 天,相对同期全市场中位数的超额收益
结论分三层。
第一层,动量类有效。四个正超额策略统计上都站得住,样本量最小的旗形也有 6400 个信号,RPS 的 t 值冲到 26.9,这个置信水平在量化研究里非常少见。而且有个共同规律,持有越久超额越高,RPS 从 5 日的 +1.03% 涨到 20 日的 +2.65%。兑现需要时间,今天出信号明天就卖,赚不到大头。
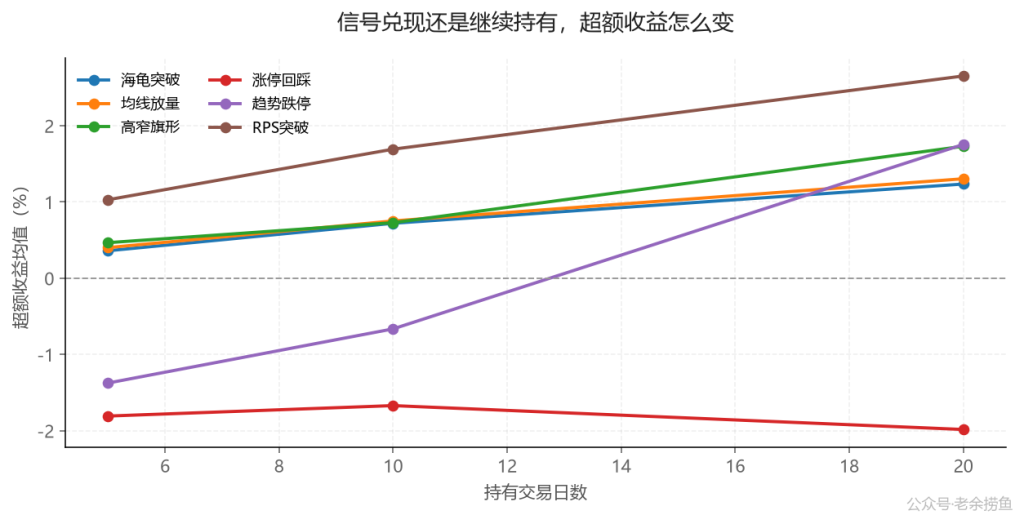
持有 5/10/20 天,超额收益怎么变
第二层,有一个要熬。趋势跌停前 10 天全是负超额,第 20 天翻正到 +1.75%。前面那十天大部分持有者已经拿不住离场了,吃得到尾部的人极少。
第三层,有一个是坏的。涨停回踩,昨天涨停今天放量收阴守住昨收盘,短线圈子里流传很广的”回踩确认”逻辑,两年 1418 个样本,5 天、10 天、20 天全线负超额,胜率 35%。这个形态在这套数据里更像上涨动能的终点。样本区间就两年多,风格切换一次结论可能变,但至少在这里,它是六个策略里唯一连正超额都摸不到边的。项目把它跟其他五个并列推送,用户拿到手无法区分。这就是没有回测模块的代价,策略的死亡率,系统自己不知道。
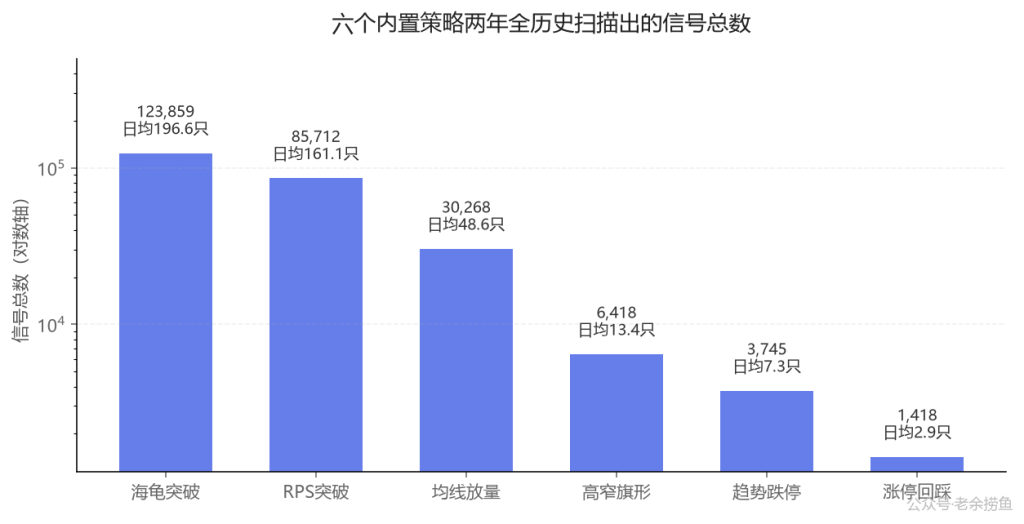
六个策略两年扫出的信号总数,对数轴
信号规模也值得看一眼。海龟日均选出 196.6 只,等于每天推一个 200 只股票的列表,只能当粗筛池。涨停回踩日均 2.9 只。信号数量决定了你拿它当初筛还是当盯盘。
三、怎么装,十分钟的事
环境要求就一条,Python 3.10 以上。Mac、Linux、Windows 都行,有一台不关机的机器更好。整个过程五步。
第一步拿代码。git clone https://github.com/sngyai/Sequoia-X.git,或者直接在页面上下 zip 解压。
第二步装依赖。推荐用 uv,一个 Python 包管理器,比 pip 快得多,uv sync 一条命令装完。没有 uv 就用老办法,pip install .。
第三步配飞书。复制 .env.example 成 .env,里面只需要填一行,飞书机器人的 Webhook 地址。机器人不用审批,飞书群里点设置、添加自定义机器人,建好就能拿到地址。想给不同策略分群,照着 .env.example 里的注释加 STRATEGY_WEBHOOK_ 前缀的变量就行。
第四步首次回填。python main.py --backfill,约 12 分钟拉完全市场历史 K 线,落在 data/sequoia_v2.db。跑一次以后就不用再跑。
第五步日常运行。python main.py,两三分钟跑完,哪个策略选出股票,就推到对应机器人。
想全自动,加一条 crontab,每个交易日 19:15 自动执行。
15 19 * * 1-5 cd /root/Sequoia-X && .venv/bin/python main.py >> log.txt 2>&1一句提醒。免费版飞书就有自定义机器人,个人用不需要企业版。全套跑起来内存占用不大,最低配的云服务器或家里旧笔记本都够。
四、装好之后怎么用
我的用法是把它放在流程的第一格。
以最近一个完整交易日的真实输出为例。收盘后系统跑完,海龟群 228 只,RPS 群 101 只,旗形群 25 只,均线群 19 只,涨停回踩群 6 只,去重后一共 358 只。这 358 只就是当天的初筛池,对应第二节数据里的含义,动量类为主。
然后是它做不了的部分。二次验证,基本面、行业位置、仓位约束,都过一遍才进自选。回测里那个全线负超额的涨停回踩群,我直接静音了。
一句话定位。它替你省掉的是每天翻涨幅榜的那半小时,省不掉的,是判断本身。
以上是普通读者的部分,装上就能用。往下是动手部分,写给想自己跑回测、想改策略的人。
五、进阶,数据这关我是怎么过的
要复现回测,得先备齐数据,全市场 5558 只、2024 年至今的后复权日 K。这一步我原以为最简单,结果花的时间比回测本身还长,三连坑实录。
第一坑,baostock 黑名单。按原项目路子 8 进程并行拉取,头几分钟很顺,一个半小时后卡死。重新登录,服务器回了八个字,黑名单用户,请与管理员联系。README 写的”无限流”,实测含义是不限次数、限并发强度。
第二坑,东财拒连。换 akshare,底层是东方财富接口。这台机器的网络环境里,东财 CDN 直接拒绝连接,curl 和 Python 全挂。
第三坑,腾讯限流。换腾讯接口,前 700 只飞快,四秒一百只,然后开始返回空内容。
最后跑通的组合是新浪的两个接口,一个给不复权日 K,一个给复权因子,两个一乘,后复权数据就有了。5558 只、344 万行 K 线,九分钟拉完,全程零断流。
不过数据过关不等于数据干净。我后来拿通达信和腾讯两个独立源对拍,发现一个藏得深的坑:新浪的复权因子停在 2022 年底就不更新了。这意味着 2023 年以后分过红、送过转的老牌股,后复权价在除权日附近会有一两个点的假跳空。全市场受影响的大概 20 只,占比不到 0.4%,对 22 万个信号的大盘统计冲不散,但你自己搭管线时要留意。免费源的复权因子不是实时维护的。
这段对你搭自己的数据管线有直接参考价值。免费数据源的真实边界,文档里从来不写。
六、动手区,核心代码
① 数据回填(新浪K线×复权因子,多线程)
import requests
import re
import json
import time
import bisect
from concurrent.futures import ThreadPoolExecutor, as_completed

HDR = {"User-Agent": "Mozilla/5.0", "Referer": "https://finance.sina.com.cn"}
PXY = {"http": None, "https": None}   # 关键:绕开系统代理

KLINE = ("https://quotes.sina.cn/cn/api/jsonp_v2.php"
         "/var%20d=/CN_MarketDataService.getKLineData")


def fetch_pair(sym, start="2024-01-01", end="2026-09-09"):
    # 1) 不复权日K
    r = requests.get(KLINE, params={
        "symbol": sym, "scale": "240", "ma": "no", "datalen": "640"},
        headers=HDR, proxies=PXY, timeout=15)
    raw = json.loads(re.search(r"\((\[.*\])\)", r.text, re.S).group(1))
    raw = [k for k in raw if start <= k["day"] <= end]

    # 2) 后复权因子
    r2 = requests.get(
        f"https://finance.sina.com.cn/realstock/company/{sym}/hfq.js",
        headers=HDR, proxies=PXY, timeout=12)
    fd = json.loads(re.search(r"=(\{.*\})", r2.text, re.S).group(1))
    fac = sorted((x["d"], float(x["f"])) for x in fd["data"])

    # 3) 合成后复权:价格 × 当日生效因子
    dates = [d for d, _ in fac]
    vals = [f for _, f in fac]
    out = []
    for k in raw:
        i = bisect.bisect_right(dates, k["day"]) - 1
        f = vals[i] if i >= 0 else vals[0]
        o, h, l, c = (float(k["open"]), float(k["high"]),
                      float(k["low"]), float(k["close"]))
        v = float(k["volume"])
        out.append((sym, k["day"], o*f, h*f, l*f, c*f, v,
                    v * (o+h+l+c)/4))   # 成交额估算
    return out
② 六策略信号(照抄项目口径,向量化)
import pandas as pd


def indicators(g):
    """单只股票全部指标,一次算完。"""
    g = g.sort_values("date").reset_index(drop=True)
    c, h, l, o, v = g["close"], g["high"], g["low"], g["open"], g["volume"]

    g["bars"] = range(1, len(g) + 1)
    g["ma5"], g["ma20"] = c.rolling(5).mean(), c.rolling(20).mean()
    g["ma60"] = c.rolling(60).mean()
    g["vol_ma20"] = v.rolling(20).mean()
    g["fwd10"] = c.shift(-10) / c - 1          # 信号后10日收益
    g["high20_prev"] = h.shift(1).rolling(20).max()   # 海龟:前20日最高
    g["prev_close"] = c.shift(1)
    g["prev_ma5"] = g["ma5"].shift(1)
    g["prev_ma20"] = g["ma20"].shift(1)
    g["prev_ma60"] = g["ma60"].shift(1)
    g["high40"], g["low40"] = h.rolling(40).max(), l.rolling(40).min()
    g["high10"], g["low10"] = h.rolling(10).max(), l.rolling(10).min()
    g["vol20_prev"] = v.shift(1).rolling(20).mean()
    g["prev_close2"] = c.shift(2)
    g["prev_volume"] = v.shift(1)
    g["ret120"] = c / c.shift(120) - 1
    g["roll_high120"] = h.rolling(120, min_periods=60).max()
    return g


def six_signals(df):
    """六个策略的布尔信号,逐条对齐项目源码。"""
    b = df["bars"]
    return {
        "turtle": (b >= 21)
                  & (df.close > df.high20_prev)
                  & (df.turnover > 1e8)
                  & (df.close > df.open)
                  & (df.close > df.prev_close),
        "ma_volume": (b >= 20)
                     & (df.prev_ma5 < df.prev_ma20)
                     & (df.ma5 > df.ma20)
                     & (df.volume > df.vol_ma20 * 1.5),
        "high_tight_flag": (b >= 40)
                           & (df.high40 / df.low40 > 1.6)
                           & (df.high10 / df.low10 < 1.15)
                           & (df.low10 >= df.high40 * 0.8)
                           & (df.volume < df.vol20_prev * 0.6),
        "limit_up_shakeout": (b >= 3)
                             & (df.prev_close >= df.prev_close2 * 1.095)
                             & (df.close < df.open)
                             & (df.volume > df.prev_volume * 2.0)
                             & (df.low >= df.prev_close),
        "uptrend_limit_down": (b >= 60)
                              & (df.prev_ma20 > df.prev_ma60)
                              & (df.close <= df.prev_close * 0.905)
                              & (df.volume > df.vol_ma20 * 2.0),
    }
③ 超额收益体检(对比同期市场中位数)
def excess_report(df, sig):
    """信号后10日收益 vs 同日全市场中位数。"""
    bench = (df.dropna(subset=["fwd10"])
               .groupby("date")["fwd10"].median())   # 当日基准
    sub = df[sig].dropna(subset=["fwd10"])
    excess = sub["fwd10"] - sub["date"].map(bench)
    n = len(excess)
    t = excess.mean() / excess.std(ddof=1) * (n ** 0.5)
    print(f"信号 {n} 个 | 超额均值 {excess.mean():.2%} "
          f"| 胜率 {(excess>0).mean():.1%} | t={t:.1f}")
    # RPS 信号(横截面排位,单独算)
    # df["rps"] = df.groupby("date")["ret120"].rank(pct=True) * 100
完整可运行版本(含股票列表拉取、SQLite 落库、断点续传、RPS 横截面计算)到 http://www.laoyulaoyu.com/code/sequoia-repro.zip 获取。
观点总结
把 22 万个信号翻译成人话。
这套系统选股票,五个策略选出来的,持有两周平均能比市场多赚一个百分点上下,RPS 类最强。一个策略选出来的,持有越久越亏。它自己不知道这件事,因为它的世界里只有今天。所以正确的打开方式,让它当你的粗筛工人,别让它当你的决策者。三分钟扫完全市场省下来的时间,正是你用来做二次验证的时间。工具的价值从来不是替你判断,是把判断需要的数据,在你下班之前摆上桌。
你的二次验证里最重的那条是什么,是估值、行业,还是仓位规则?评论区聊聊,下一篇我把”二次验证”拆成可执行的清单。
觉得有用的话,把这篇转给同样在搞量化的朋友。
#量化选股 #开源项目 #Python量化 #SequoiaX #A股 #技术形态 #程序化选股 #量化复盘 #GitHub开源 #选股系统 #量化工具 #动量策略
免责声明:本文所有数据均为历史回测结果,不构成任何投资建议。历史表现不代表未来收益。量化策略存在失效风险。市场有风险,投资需谨慎。
Be First to Comment