作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。
模型评测不等于投资建议。
不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 6500 字 | 预计阅读 12-20 分钟,后有代码和数据来源,建议先收藏
1984年,在哥伦比亚大学的一场演讲中,巴菲特提出了一个问题:投资赚钱,到底靠本事还是运气?那天是《证券分析》出版50周年,台下坐着一屋子相信市场有效的人。
他讲了个思想实验。假设美国有2.25亿人,每人拿一美元猜硬币,猜错就出局。连续玩20天后,可能只剩下215名赢家,每人都把1美元变成了100多万美元。有人说,把人换成猩猩,结果也一样。巴菲特却提醒大家:如果这215个赢家里,有40个都来自奥马哈同一个“动物园”,你还会觉得只是巧合吗?他把这个地方称为“格雷厄姆—多德村”,想说明一群人若长期使用相似的方法、取得相似成绩,就不能轻易把一切归结为运气。
当时,他列出了九份投资记录。其中,他自己的合伙公司在1957—1969年年化收益率为29.5%,同期道指为7.4%;扣除分成后,有限合伙人实际拿到的年化收益率为23.8%。本文将采用后一个、相对保守的数字。
另一份更长的成绩单来自伯克希尔:1965—2025年,每股市场价值年化增长19.7%,标普500含股息年化回报为10.5%。我也想知道,这样的成绩有多难靠运气碰出来,于是用同一套方法重新计算了几段记录。
一、先看结果
| 记录 | 年数 | 年均超额(百分点) | t值 | 单个对象靠运气达到该成绩的概率 |
|---|---|---|---|---|
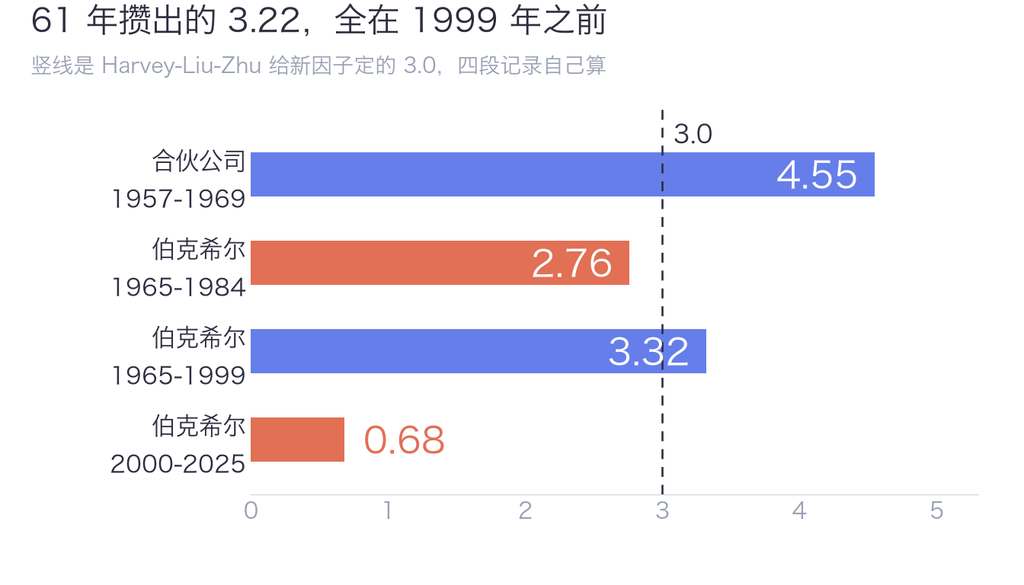
| 合伙公司 1957-1969 | 13 | 15.71 | 4.55 | 0.031% |
| 伯克希尔 1965-1984 | 20 | 23.55 | 2.76 | 0.36% |
| 伯克希尔 1965-1999 | 35 | 19.17 | 3.32 | 0.048% |
| 伯克希尔 2000-2025 | 26 | 1.92 | 0.68 | 24.5% |
合伙公司时期的表现很突出,伯克希尔从1965年算到1999年也很强。但单看2000年以后,数据就没那么有说服力了。这不等于说巴菲特突然不会投资,也不代表伯克希尔没赚钱;它说明,赚了多少钱和是否有稳定的超额收益优势,是两回事。
二、t值是什么,3.0这条线谁定的
简单说,t值是在比较:平均超额收益,相对于它本身的波动,到底有多突出。收益越稳定、观察时间越长,t值通常越高。
为什么参考3.0这条线。2015年Harvey、Liu和Zhu发过一份NBER工作论文,把316个已发表因子过了一遍,结论是新因子最好t大于3.0才算数。这门槛本来是给因子定的,不是给基金经理定的,我没找到更接近的标准,只能当尺子。伯克希尔到1984是2.76,差0.24个点。
三、把“运气”模拟出来
合伙公司这13年,年均超额收益为15.71个百分点,年度超额的标准差是12.44个百分点。我先把平均优势拿掉,只保留年度成绩的起伏,再从这些数据中有放回地抽样,拼成新的13年记录,重复40万次,看看有多少次能达到原记录的t值4.55。
结果是124次,约占0.031%,相当于三千多次里才有一次。这种方法叫“自举法”。它不是说现实中真的发生了40万段人生,而是用模拟来估计:如果投资者并没有平均优势,类似成绩有多容易出现。
看到124这个数字,我停了一会儿。运气也能做出一份很像真本事的成绩单。关键不是它能不能发生,而是它有多常见。
但这里还有个问题:我们看到的赢家,是不是从很多人里挑出来的?
四、关键变量是:一共试过多少人?
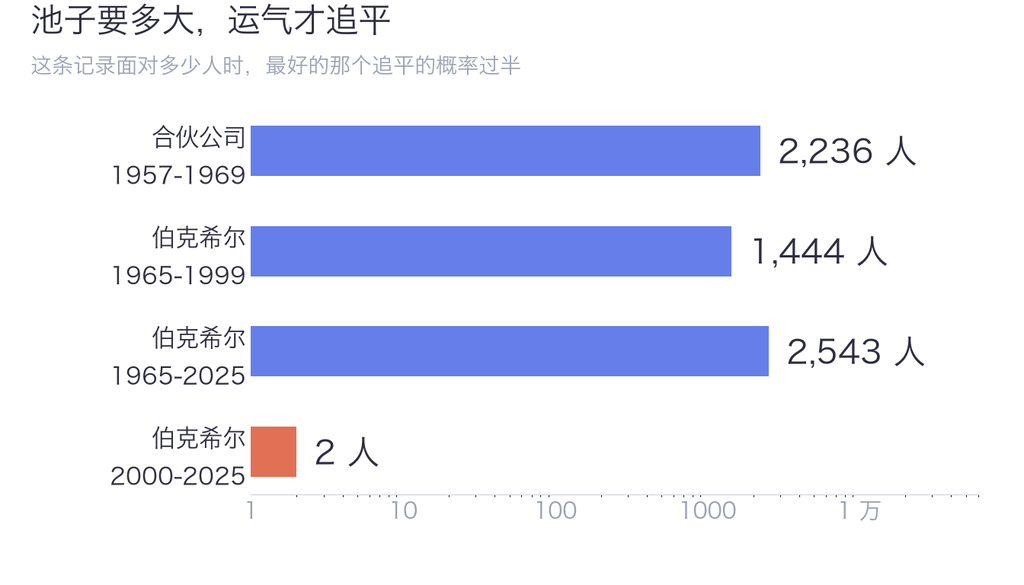
0.031%只回答了“单看一个管理人,这个成绩有多难碰到”。现实中,赢家往往是从很多管理人里被挑出来的,失败者却很少进入我们的视线。参赛人数越多,就越容易冒出一个靠运气跑到前面的冠军。统计上可以用N表示比较对象的数量。
假设有215位没有超额收益优势、但波动程度相近的管理人,至少有一个人的成绩靠运气达到合伙公司t值4.55的概率,就会从0.031%升到6.4%。这不是说巴菲特有6.4%的概率靠运气成功,而是说:如果215个人都参加比赛,即使人人没有优势,也有6.4%的机会出现一个这样的“幸运冠军”。
这里的215是方便比较的假设,不是准确的历史参赛人数。真实世界里到底有多少管理人该放进同一个池子,没有明确答案。我不想随意把N扩大到几千,再用自己定的人数得出想要的结论。
计算公式是:1 − (1 − p)ⁿ。按“最好的那个仅靠运气追平成绩的概率超过50%”作为另一条参考线,合伙公司这段记录大约能经受2236人的比较;伯克希尔1965—1984年的市场价值记录,则约到192人就会越过这条线。
还有个细节:伯克希尔1965—1984年,按每股市场价值算出的t值是2.76,换成每股账面价值则是3.61。换一列数据,结论就变了。合伙公司部分,我选的是扣除分成后有限合伙人实际拿到的收益;未扣分成的t值是5.97,数字更漂亮,但我采用了保守口径。
统计结论不只取决于数字,也取决于选了什么数据、怎样定义问题。
五、巴菲特的论证,关键在“提前点名”
重读1984年的演讲,我发现最值得注意的并不是“一个村子里出了很多赢家”,而是巴菲特强调:这些人的投资方法在很多年前就已经被识别出来。他不是看到结果后才从几千份记录中挑出九个赢家,而是先点名,再看成绩。
用今天的话说,这相当于提前公布了名单。九份记录就是九个事先选定的样本。按同样的计算,九个人里最好的那个靠运气达到合伙公司t值4.55的概率约为0.3%。
这让他的论证有了分量。当然,它也不是没有局限:那些同样读《证券分析》、采用类似方法却表现平平的人,并不会出现在赢家名单里。他们无法作为反例被我们看到。九份记录当初如何挑选,也主要依赖巴菲特本人的叙述。
所以,我不会说这场演讲彻底排除了运气。它真正提醒我们的,是别只看赢家的成绩,还要看这些赢家是怎么被选出来的。
六、61年的成绩,为什么拆开看就不一样
回到伯克希尔的61年纪录。乍一看,时间越长,成绩似乎越能说明问题。但把这段记录拆开以后,事情就没那么简单了。
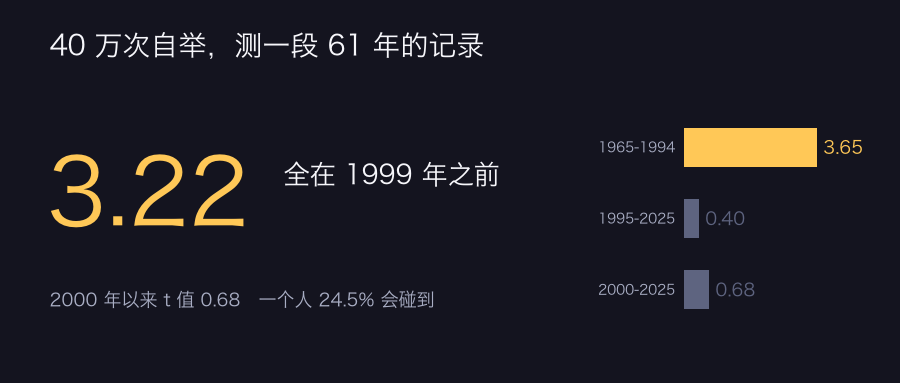
1965年至1984年,伯克希尔年均超额收益为23.55个百分点,t值2.76。把终点延长到2025年,样本扩大到61年,年均超额收益降到了11.82个百分点,年度差距的波动也有所收窄,整体t值为3.22。
这份长达61年的记录,整体看依然能越过3.0参考线。但这并不意味着它在每个阶段都一样强。分段来看,1965年至1994年的t值是3.65;1995年至2025年则只有0.40。尤其是2000年至2025年,t值也只有0.68。
也就是说,整体成绩很好,并不代表优势在整个时期都同样明显。早期的强势表现,会把后面几十年的数据一起托起来。
我也担心过另一种可能:是不是因为我特意挑了1999年这个分界点,才得到想要的结论?毕竟这是看完数据后才选出的切点。
为了减少这种疑虑,我又把计算起点从1998年逐年往后挪到2010年,重新计算2000年以后各段记录。13个起点里,最高的t值也只有0.68,最低为-0.70。换几个起点,结果都没有明显变好。
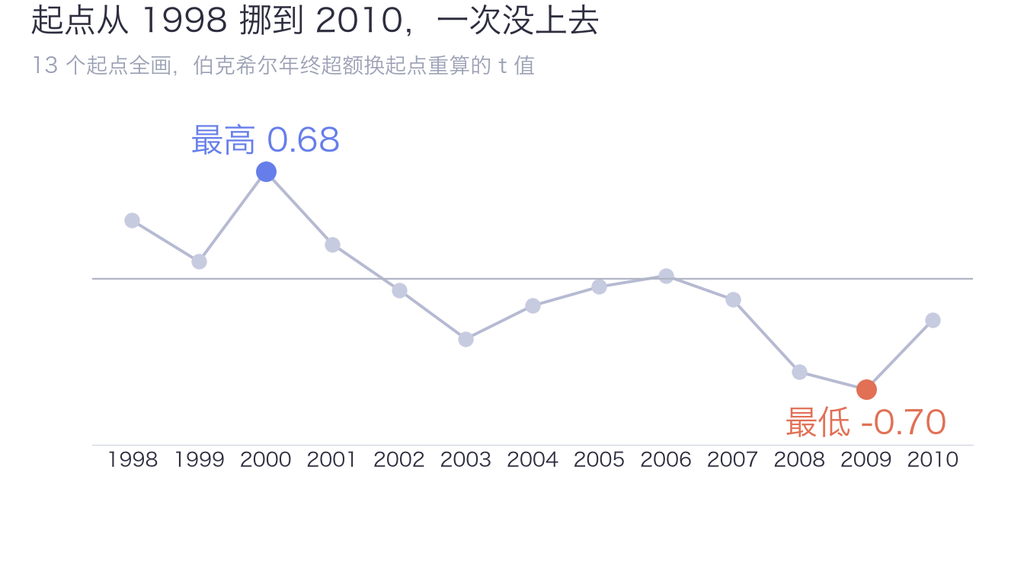
每次将起点往后挪一年,重新计算对应时期的t值。这至少说明,2000年以后结果不够突出,并不完全是因为我挑了某一个特殊的起点。
七、0.68到底在说什么
24.5%,四个人里一个。2000到2025,伯克希尔年均还领先标普1.92个百分点,可年度差距摆动14.48个百分点,这点领先被埋在噪音里。
有人认为伯克希尔的波动比市场低,直接比超额收益会低估能力。我当时也这么想,就按这说法跑了回归,年收益对标普,斜率0.53,截距6.47,t值2.40,26个年度观测测不到3.0。
Frazzini、Kabiller、Pedersen把伯克希尔整个历史拆过一遍,估出杠杆约1.6倍,控住BAB和QMJ两个因子后alpha就不显著了。承认一家老牌公司的优势可能只是杠杆和风格,并不容易。但研究要做的是看清收益从哪来,不是替喜欢的对象找理由。看到这个我松了口气,说不清为什么。
那1.92个点够不够?要让t摸到3.0,得有多长的记录。
512年。按这26年的年均超额和波动往下推,要500多年才凑够一次3.0。换成回归里的alpha 6.47,标准误2.69,t随年数开方长,摸到3.0得等40年。前提是均值和波动不变、各年不相关,现实里未必成立,但方向不会差太远。
不过把26年摊开看,跑输的那10年里标普一次都没跌过。跑输年份标普平均涨16.9%,没跑输年份只涨5.2%。最差是2009年,标普涨26.5%,伯克希尔少赚23.8个点。
这不像能力突然消失了,更像它躲开了所有上涨的年份,2000年之后涨得最猛的那些年涨的是科技股。答案有两个,错过科技股和规模拖累。后一个巴菲特1984年演讲就提过,规模大了能挑的标的就少,超额幅度跟着缩小,不用猜他判断力退步。
八、我把这条线画到2030年
既然研究的是长期优势,能不能提出一个可以在未来检验的判断,而不只是回头解释过去?
我给自己设了一条简单的观察线:从2026年到2030年,伯克希尔每股市场价值的年化回报,需要比标普500含股息回报高出至少2个百分点。五年结束后,我们再看结果。达不到,就算我这次判断错了。
回看历史,和这段时间相对应的连续五年窗口并不多。按每五年为一组、前后相接的方式计算,一共只有五组,其中三组超过每年2个百分点,两组没超过。
| 五年窗口 | 年均超额 | 过2个点 |
|---|---|---|
| 2000-2004 | 11.69 | 过 |
| 2005-2009 | 2.01 | 刚过 |
| 2010-2014 | 2.43 | 刚过 |
| 2015-2019 | -3.23 | 没 |
| 2020-2024 | 0.41 | 没 |
只有五组数据,样本实在太少,不能据此给出多么可靠的概率。我原本想按历史六成左右的比例估计,但最近两个窗口都没有超过这条线,所以自己把预期再往下调了一些。这个概率更多是我的主观判断,不是严谨的统计结论。
这里还有个容易被忽略的口径问题。我看到有一种算法,把22个滚动五年窗口算出14个超过门槛。我按“年化超额收益每年超过2个百分点”重新数,结果只有8个。原因是前一个数字看的是五年累计超额超过2个百分点,摊到每年还不到0.5个百分点。门槛看起来只差几个字,实际问的却是两件不同的事。
九、我也把这套方法用在A股
面讨论的是巴菲特。接下来,我想看看这套检验放到自己熟悉的A股策略里,会得到什么结果。
我选了沪深300ETF(510300),时间范围是2013年1月至2025年12月,共13个完整年度。策略很普通:双均线。快线设置在5至60天之间,慢线设置在20至250天之间,只有快线高于慢线时才持仓。收盘后产生的信号,第二天才执行;每次换仓计入0.05%的交易成本。一共测试了263组参数。
结果不太好看:263组参数的t值中位数是-0.46,最高也只有0.14,t值大于0的组合占6.8%。换句话说,跑了一大圈,没有一组接近3.0这条参考线。
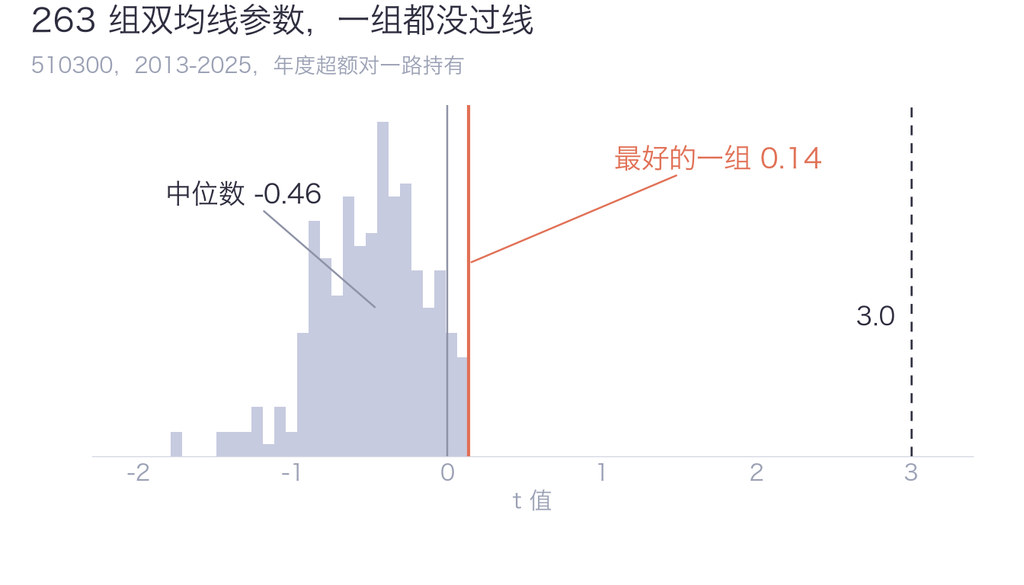
263组参数里,表现最好的一组也离3.0参考线很远。
表现最好的是30日均线搭配90日均线。它的年化收益率为7.70%,略高于同期一直持有510300的7.25%。但这点差距放进年度波动里看,t值只有0.14。
我盯着这个结果看了好几遍,还专门回头检查信号有没有错位、有没有不小心用到未来数据。确认是收盘产生信号、第二天才执行之后,结果还是0.14。
当然,双均线策略有时会降低仓位、控制回撤,单看超额收益未必能体现全部价值。所以我也补做了回归分析,alpha的t值仍然只有0.56。263组参数试下来,最好的一组靠运气被碰上的概率几乎是必然会发生的事。
这个结论只针对这次测试的标的、时间范围、参数区间和交易规则,不能直接推成“双均线策略在任何市场都没用”。但对这组数据来说,我没有找到能被统计结果支持的超额收益优势。
说实话,看到263组参数全都没有过线,我反而松了口气。至少结果很一致,不是只有某个参数特别好看、其他组合却都差不多,而是整个参数范围都没出现明显优势。当然,这并不证明未来永远如此,只说明这次回测没有给我足够理由把它当成可靠策略。
我还想继续追问一件事:即使历史上某只资产表现最好,我们又能不能提前挑中它?我又做了一个小实验。选了17只美股ETF,覆盖标普500、小盘股、黄金、原油等不同资产,以SPY(标普500 ETF)作为基准。每次先看过去四年的表现,选出其中成绩最好的一只,然后观察它在接下来四年的表现。一共测试了12个起点。
结果是:过去四年里,冠军ETF平均比标普多赚12.4个百分点;但到了接下来的四年,它的平均超额收益变成了-0.1个百分点。12次里有7次跑赢标普、5次跑输,整体看和闭眼挑一只差不多。
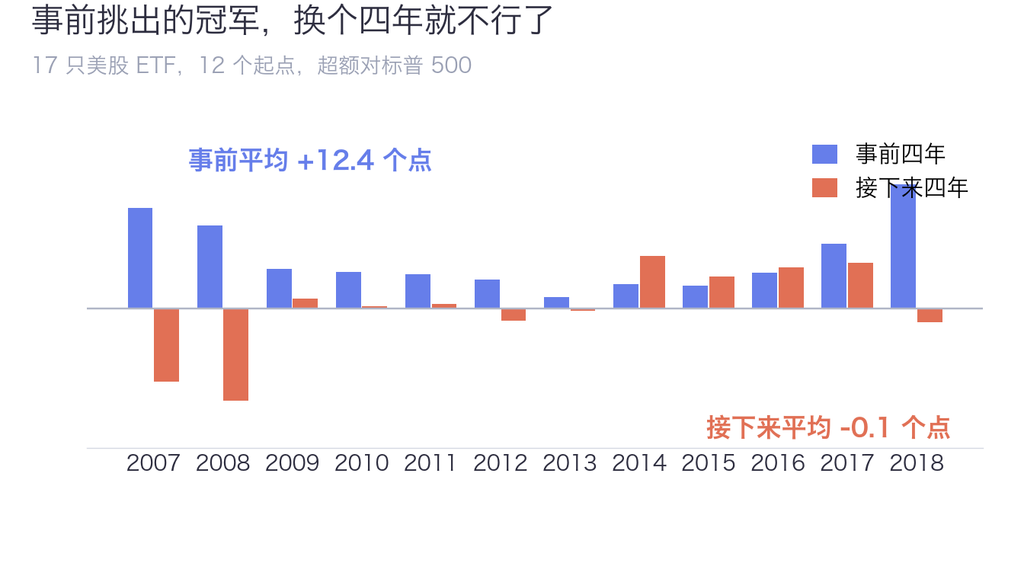
17只美股ETF:过去四年挑出的冠军,未能在接下来的四年持续领先。
有一点倒是挺有意思:过去的排名和未来的排名,并不是完全没关系,相关性约为0.349。和打乱年份顺序后得到的随机结果相比,这个相关性明显更高。
这说明一些市场风格确实可能延续一段时间,比如某个阶段黄金表现强势。但这不代表我们能稳定挑中下一阶段的赢家。12次测试里,过去四年第一名的ETF,只有一次在接下来四年仍然排第一,占8.3%。
真正值得警惕的情况是:我们试了很多组参数或很多种资产,最后只拿出最漂亮的一组,然后把它当成方法有效的证据。那组结果也许不是假的,只是我们忽略了自己曾经试过多少种可能。
十、想检查自己的策略,可以怎么做?
如果你也做过回测,可以先从一份最简单的年度超额收益记录开始。下面这段Python代码,把本文用到的基本步骤放在了一起:计算t值、模拟没有平均优势时的结果,再估算从N个候选对象里挑出一个高分的概率。
import numpy as np

def luck(excess, n_field, draws=400_000, seed=20261020):
    """excess 是每年的超额收益(%),n_field 是试过多少次"""
    e = np.asarray(excess, dtype=float)
    t = e.mean() / (e.std(ddof=1) / np.sqrt(e.size))
    rng = np.random.default_rng(seed)
    null = rng.choice(e - e.mean(), (draws, e.size))        # 优势归零,波动照旧
    t_null = null.mean(1) / (null.std(1, ddof=1) / np.sqrt(e.size))
    p = (t_null >= t).mean()                                # 一个人碰上的概率
    return dict(t=round(t, 2), p=round(p, 5),
                one_in=int(1 / p) if p else None,
                best_of_field=round(1 - (1 - p) ** n_field, 3))

dow = [-8.4, 38.5, 20.0, -6.2, 22.4, -7.6, 20.6, 18.7, 14.2, -15.6, 19.0, 7.7, -11.6]
lp = [9.3, 32.2, 20.9, 18.6, 35.9, 11.9, 30.5, 22.3, 36.9, 16.8, 28.4, 45.6, 6.6]
print(luck(np.array(lp) - np.array(dow), n_field=215))
# {'t': 4.55, 'p': 0.00031, 'one_in': 3225, 'best_of_field': 0.064}
代码做的事可以拆成四步:先算每年的超额收益;再计算t值;接着把平均优势拿掉,重复抽样40万次,看看运气能做到多好;最后,再把你比较过的候选对象数量N放进公式,看看这么多对象里至少有一个“幸运赢家”的机会有多大。
这里最容易让人误会的,是第三步算出来的p值。它看起来很小,但如果你已经试过很多策略、很多组参数,最后才挑中这一组,那么只看p值就可能高估它的可信度。
还要提醒一句:这段代码是用来演示思路的简化版本,不是能适用于所有策略的万能检验。真实研究中,收益序列是否独立、波动是否稳定、参数是怎么筛选出来的,都会影响结果。特别是当你试过很多组参数时,最好把整个筛选过程也纳入检验,而不是只检查最后留下来的那一组。
回到奥马哈那个动物园
这次重新计算之后,我对1984年那场演讲有了不同的理解。
巴菲特的论证最有力的地方,不只是一个村子里出现了很多投资赢家,而是他声称这些人的名字早在成绩揭晓之前,就已经被点了出来。先确定研究对象,再看结果,和看到结果后只挑赢家,是完全不同的两回事。
伯克希尔的长期成绩依然值得尊重。但把时间拆开看,早期的优势更明显,2000年以后这26年的数据,则不足以单独证明它仍然拥有同样清晰的超额收益优势。它依然可以赚钱,也可能有其他值得肯定的地方;只是“它赚了钱”和“它持续跑赢市场的能力已被这段数据证明”,并不是同一个结论。
至于N究竟该怎么算——按尝试过的参数组数,还是按研究者试过的策略思路?这件事没有一个我敢说绝对正确的答案。我的263组参数,至少是把实际试过的组合数摆在桌面上了。对自己的研究来说,这总比只展示最后那一组漂亮结果诚实一些。
如果你手里也有一套回测结果,不妨先问问自己:从最初想到这个策略,到最后决定把钱投进去,中间一共试过多少种方法、改过多少次参数?
我们很容易记住那个跑赢市场的策略,却忘了此前被自己淘汰掉的几十组、几百组尝试。可那些没留下来的结果,同样是这次研究的一部分。
回测最怕的,未必是结果不好看,而是试了很多次以后,只把最好看的那一次当成真相。
来源与口径说明:
- 合伙公司数据:1984年哥伦比亚大学演讲文本中的Table 3,采用有限合伙人和道琼斯指数对应数据,年份为1957—1969。
- 伯克希尔每股市场价值及标普500含股息数据:伯克希尔2025年致股东信中的“Berkshire’s Performance vs. the S&P 500”表,覆盖1965—2025年。
- 伯克希尔每股账面价值数据:伯克希尔2018年致股东信中的同名表,覆盖1965—1984年。
- t值3.0参考门槛:Harvey、Liu与Zhu的NBER工作论文《…and the Cross-Section of Expected Returns》。该门槛原本针对金融因子研究,本文将其作为比较参考,而非普适定律。
- 自举法与数据窥探框架:Hal White,《A Reality Check for Data Snooping》,Econometrica,2000年。
- 伯克希尔杠杆与因子归因:Frazzini、Kabiller与Pedersen,《Buffett’s Alpha》,NBER工作论文。
- 分析框架参考Navnoor Bawa于2026年10月20日发布的公开文章。文中数字按作者采用的口径重新计算。
- 关于滚动五年窗口,本文按“年化超额收益每年超过2个百分点”的口径重数为8个;另有算法得到14个,采用的门槛口径不同,不能直接比较。
- A股回测和美股ETF实验为作者独立实验,原始代码文件为
repro_ashare.py及repro_luck.py。
#巴菲特 #量化回测 #数据窥探 #过拟合 #自举法 #统计学 #A股量化 #510300 #双均线 #策略研究 #量化开发
觉得有用的话,把这篇转给同样在跑回测的朋友。
Be First to Comment