作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
文中示例仅用于技术讨论,不构成任何操作建议。
量化策略开发应以学习和技术交流为目的。
本号不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3500 字,另有 5 段代码 | 预计阅读 8 分钟。前半是介绍、安装和用法,后半有源码核实与实测过程,建议先收藏。
· · ·
GitHub上有个开源项目叫LangAlpha,自我定位是金融市场的Claude Code,Apache-2.0 协议,代码全公开。
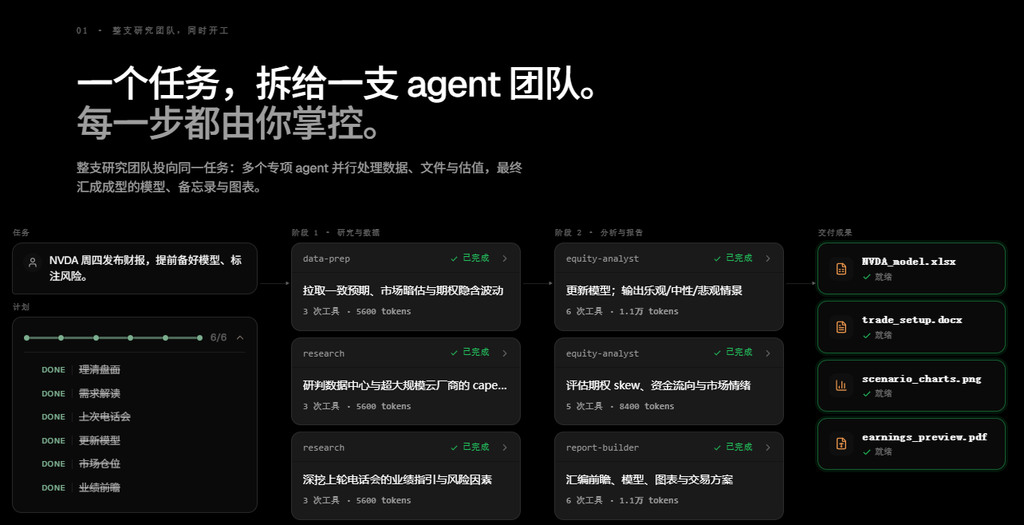
它干的活儿是做投研。你给一个研究目标,它在沙箱里写代码拉数据、算模型、出图表,最后交出一份能打开的文件,Excel 模型、PDF 报告,或者一块能点的实时看板。
我把它的源码拉下来读了一遍(AI配合人工),加上前端一共 46 万行代码,又单独把它的证券代码统一层跑了一轮,让大家读完这篇文章后对LangAlpha能有个比较客观的了解。
这篇文章分两半。前半讲它是什么、解决什么问题、怎么装怎么用,不动手也能看完。后半是我翻源码和实测的过程,包括几处它没处理好的地方。
一、它到底是什么
这类工具最近有个统称,agent harness。harness 直译是马具,管的是马能不能拉动车、走多远、路上听不听指挥,不掺和马自己怎么跑。
换成大白话,它是给大模型配的办公室。模型只负责理解和推理,其余全由这层壳包办。读文件、跑命令、写代码、记住上次聊到哪、中途打断改方向、同时开几摊活儿。
Claude Code、Cursor 这些是通用办公室,什么行业都能搬进去。LangAlpha 是专做投研的那一间,桌椅按投研的活计摆。
它 2026 年 1 月开源,到现在八个月。GitHub 上 1756 个星,288 次 fork,28 条待办。我 clone 的当天上午,它的提交记录还停在几个小时前。
它不是唯一选择。给通用的 AI 编程工具装上金融插件,也能做一部分投研的活。差别在哪一节会讲,先说它自己。
二、它真正想解决的问题
现在大部分 AI 金融工具都是一次性的。你问一个问题,它给一个答案,这一轮结束了。下次再问,它不记得你上次在追什么。
投研偏偏不是这么干的。你先有一个判断,然后每天有新数据进来,你根据新数据调整判断。这个过程可能跑几个星期,甚至几个月。
单次问答装不下这个过程。每次你都要重新交代背景,重新贴一遍上次的结论,重新讲清楚自己的持仓和风格。
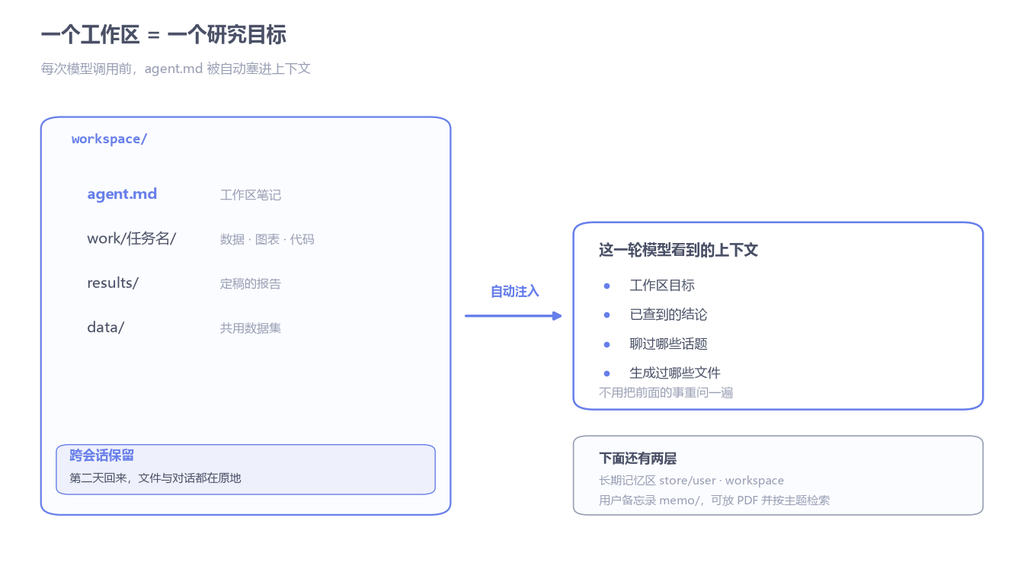
它给的答案是一个能存东西的工作区。一个工作区对应一个研究目标,比如二季度调仓,或者数据中心需求深挖。agent 在里面记笔记、存中间结果、放交付物。第二天回来,文件和对话都还在原地。
有个更好记的比法。它把 AI 编程工具里代码仓库那个位置,换成了一个投研工作台。代码每天都在长,研究也一样。
三、核心能力,我只挑四个讲
它官网列了十几项功能,全列一遍没什么用。下面四个才真正决定它能不能干活。
1. 持久工作区
这是最该看的一个。每个工作区背后是一个独立的沙箱环境,目录结构固定。
agent.md           工作区笔记,agent 自己维护,每次对话自动载入
work/任务名/        中间产物,数据、图表、代码
results/           定稿的报告
data/             多个任务共用的数据集
关键是那个 agent.md。它记着这个工作区的目标、已经查到的结论、聊过哪些话题、生成过哪些文件。每次调用模型之前,这层笔记会被塞进上下文。
打个比方,它像一本交接班记录。接班的人不用把前面的事重问一遍,翻本子就行。
再往下一层还有长期记忆区和用户备忘录。备忘录可以放 PDF,它会抽取正文、生成摘要,之后按主题找得到。
2. PTC,让 agent 写代码,而不是硬吞数据
这是它跟普通问答最不一样的地方。
一般 AI 工具取数据,是把结果直接灌进对话。一份十年财报扔进去,几万 token 就没了,还容易把上下文撑爆。
它的做法反过来。agent 在沙箱里写一段 Python,让代码去调数据、做计算、画图,只把最后的结论带回来。原始数据根本不进对话。
支撑这套流程的是一个 849 行的工具生成器。它把每个数据接口自动翻译成 Python 函数,模型像调本地函数一样调行情和财报。
举个具体场景。让它算一只票五年自由现金流的复合增速,它会写一段脚本把五年原始报表跑完,回来只给你一个数字加一张图。
3. 数据层,三层降级加十个接口
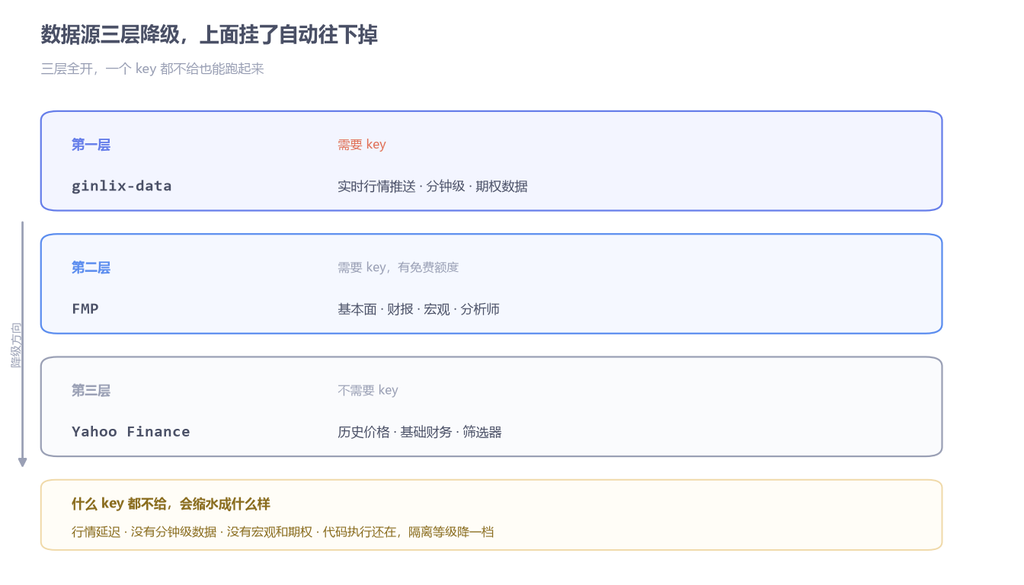
金融数据是这行的地基,也最容易出岔子。它的设计是三层降级。
| 层级 | 数据源 | 要不要 key | 多出什么 |
|---|---|---|---|
| 第一层 | ginlix-data | 要 | 实时行情推送、分钟级、期权 |
| 第二层 | FMP | 要(有免费额度) | 基本面、财报、宏观、分析师 |
| 第三层 | Yahoo Finance | 不要 | 历史价格、基础财务、筛选器 |
三层都开着,上面那层挂了自动往下掉。一个 key 都不给也能跑起来,只是功能会缩水。
内置的数据接口一共十个,分三包。行情包四个,价格、基本面、宏观、期权。雅虎包四个,价格、市场、基本面、分析师。另类数据包两个,推文检索和网页抓取。
这些接口可以在界面里单独关掉,也可以自己加。加完几秒钟生效,不用重启服务。
4. 技能库,三十七个
技能是它把投研标准动作固化下来的地方。我数了一遍,一共 37 个,分四包。
| 包名 | 数量 | 举例 |
|---|---|---|
| 投研 | 20 | 现金流估值、首次覆盖、财报分析、可比公司 |
| 交付 | 9 | Excel、Word、PPT、PDF、网页报告、看板 |
| 服务 | 6 | 定时任务、工作区管理、用户画像 |
| 另类数据 | 2 | 网页抓取、推文检索 |
数量本身不算亮点,值得看的是内容。我翻了几份技能文档,里面写的已经超出提示词的范围,更接近作业标准。
比如现金流估值那份,开头就钉死三个锚点,现价、摊薄股数、净债务,缺一个就不许往下算。来源查不到的输入,必须在单元格里标注缺失并写明查过哪里,不允许默默填一个数糊过去。
还有一条更细的。它要求模型建 Excel 时,每个推算单元格都得是活公式,用 Python 算完写死的数字算缺陷。理由是模型必须能跟着假设动,写死一个数会让后面所有勾稽关系悄悄失效。
这类规矩,才是投研和问答真正的分界线。
四、装起来要多久
最简单的是把下面这条命令喂给你电脑里的AI,让它帮你安装。
帮我安装下面这个项目,为了项目能够正常运行,授权你安装配套的支撑环境。
https://github.com/ginlix-ai/LangAlpha
如果你是老鸟,前提有这两样,安装会更稳定可控。一个 Docker,一个模型 key。数据接口的 key 不是必须的。
三条命令。
git clone https://github.com/ginlix-ai/langalpha.git
cd langalpha
make config
make up
第一条拉代码。第二条进交互式向导,它会问你用哪个模型、接不接数据源、沙箱走云端还是本地。第三条把数据库、缓存、后端、前端一起拉起来。
装完三个地址,前端 5173,后端 8000,还带一份能直接点的接口文档。
模型这块它不绑厂商。ChatGPT 和 Claude 的订阅可以走授权直连,国内的 Kimi、GLM、MiniMax、豆包也支持,或者填自己的 API key。
数据 key 全是可选项,加一个解锁一块能力。什么也不加的话,你拿到的是雅虎免费数据加本地 Docker 沙箱。行情会延迟,没有分钟级数据,也没有宏观和期权。代码执行还在,但隔离等级降了一档。
五、装好之后,一个回合这样办
你建一个工作区,写清楚目标。它不会直接开干,先反问你几个问题,问你的持仓、你的风格、这一轮想回答什么。答完它开始跑,第一份交付物会存进 results 目录。
事情没完。它会把这轮的发现写回 agent.md,把中间数据留在 work 目录。
第二天你回来接着聊。它已经知道昨天查到哪了,不用你再讲一遍。
它内部跑两套模式。大活走 PTC,用强推理模型在沙箱里写代码做深度分析。轻活走 Flash 模式,快速问答、看个行情、聊个图表。中间还有个秘书角色负责调度,你让它去跑一份深度分析,它在后台跑完,用大白话汇报回来。
再往上是自动化。可以设定时任务,比如每天早上七点出一份盘前简报。也可以设价格触发,某只票碰到你定的价位就自动跑一遍分析。结果能推送到 Slack、Discord、飞书这些常用渠道。
最后是溯源。每一轮结论旁边有个来源面板,点开能看到数据从哪个接口取的、依据是哪份文件。这个设计比”看着挺准”有用得多。
以上是普通读者的部分,装上就能用。往下是我把源码拉下来翻和跑的过程,想自己核实的接着看。
六、我把源码拉下来数了一遍
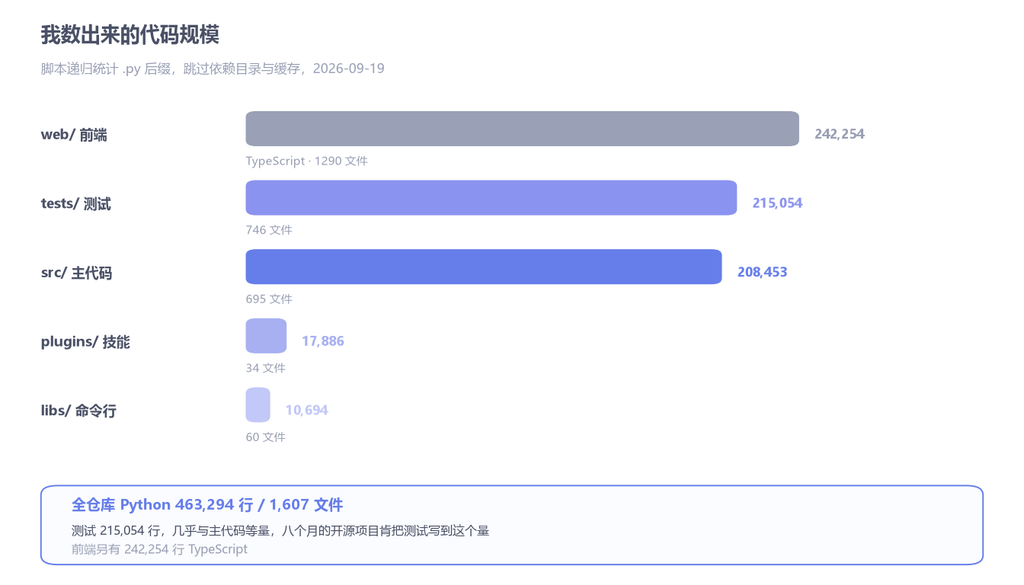
我的口径很简单,只数 .py 后缀,跳过依赖目录和缓存。
| 目录 | Python 行数 | 文件数 |
|---|---|---|
| src 主代码 | 208,453 | 695 |
| tests 测试 | 215,054 | 746 |
| plugins 插件与技能 | 17,886 | 34 |
| libs 命令行前端 | 10,694 | 60 |
| 全仓库合计 | 463,294 | 1,607 |
前端那边另有 24.2 万行 TypeScript,1290 个文件。
数字里有一点更值得说。测试代码 21.5 万行,几乎和主代码一样多。一个八个月的开源项目肯把测试写到这个量,说明它不是演示品。
主代码的目录划分也干净。market_protocol 管数据语义,ptc_agent 管智能体,data_client 管取数,llms 管模型接入,server 管接口。一层一件事。
七、我跑了它的符号层,说点实话
翻目录的时候,我最想验的是 market_protocol 这一层。
理由是它要解决的问题特别基础。同一只股票,不同数据源给的写法不一样。苹果可能叫 AAPL,也可能叫 AAPL.O。港股腾讯可能是 0700.HK,也可能是 00700。纽约和伦敦的交易日还不是同一天。这些对不齐,后面所有计算都是沙子上的楼。
它自己写了一层协议,1088 行,用 ISO 10383 的交易所代码做统一标识。
这一层正好能单独跑。它只依赖两个常见库,不需要数据库、不需要 Docker、不需要任何 key。我把主代码路径挂上,直接调它的转换函数。
import sys
sys.path.insert(0, "repo/src")
from market_protocol import to_canonical

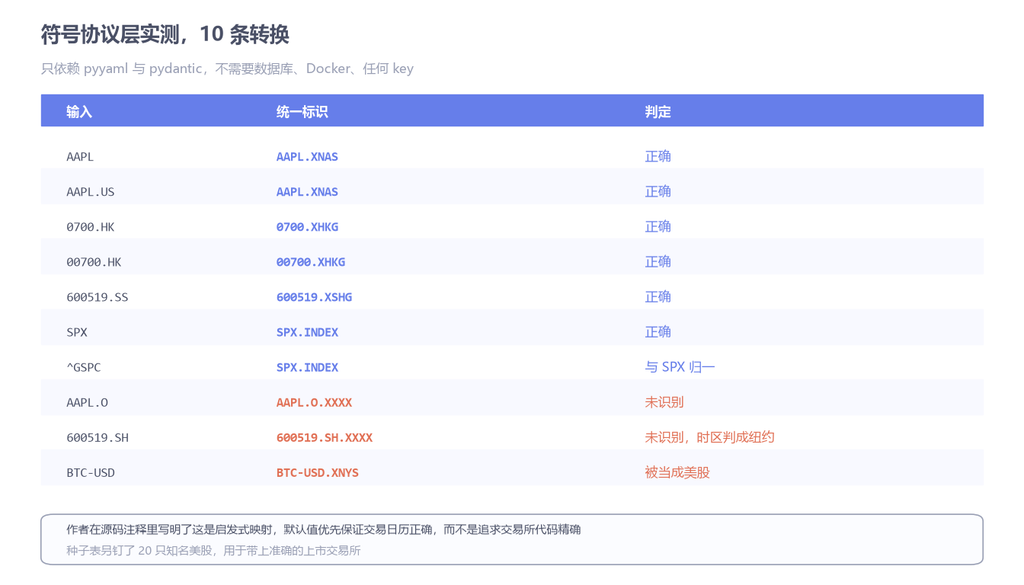
for s in ["AAPL", "AAPL.US", "0700.HK", "00700.HK", "600519.SS", "SPX", "^GSPC"]:
    print(s, "->", to_canonical(s).instrument_key)
结果是这样。
AAPL       -> AAPL.XNAS
AAPL.US    -> AAPL.XNAS
0700.HK    -> 0700.XHKG
00700.HK   -> 00700.XHKG
600519.SS  -> 600519.XSHG
SPX        -> SPX.INDEX
^GSPC      -> SPX.INDEX
主流写法全部对上。美股两种写法归一到同一个键,港股去掉了前导零,A 股按交易所拆开,沪深各有各的日历。
最漂亮的一处是指数。SPX 和 ^GSPC 是两个数据源里同一样东西的两种写法,它把这两个归到了同一个键上。这种修复靠人工维护对照表得攒很久,写进协议层就一劳永逸。
我把测试面拉宽一点,跑另一批写法,问题出现了。
AAPL.O     -> AAPL.O.XXXX       未识别
600519.SH  -> 600519.SH.XXXX    未识别,时区判成纽约
BTC-USD    -> BTC-USD.XNYS      被当成美股
三个问题。点 O 这个纳斯达克后缀不认。点 SH 不认,只有点 SS 认。裸写 BTC-USD 会被当普通股票处理,加密货币的身份丢了,必须写成完整的 BTC-USD.CRYPTO 才对。
第三个问题最实际。海外数据源里 BTC-USD 是很常见的写法,这么写进来,交易时段会按美股算。
不过我在源码里看到一段注释,作者自己写明了这些边界。原话大意是,后缀到交易所代码的映射是启发式的,一个后缀不一定能定位到具体交易所,裸写的美股代码也定位不到上市地。他们选择让默认值优先保证交易日历正确,而不是追求交易所代码精确。
这个取舍我认为理性。真实数据里绝大多数是主流写法,剩下的靠一份种子表兜底。
种子表我也数了,只钉了 20 只,苹果、微软、英伟达这些知名美股,用途是让它们的代码带上准确的上市交易所。
所以这一层的价值不在完美,在于它把一个散落在各处的判断收拢到了一处,边界也写进了注释。这比每个数据接口各自猜一遍要强。
八、它的取舍,和值不值得看
用了半天,我把它的边界归成几条。
它明确不做交易。官方问答里写得很清楚,不接券商账户,只做研究,出不出手由你决定。这是设计选择,不是功能缺失。
它的数据重心在美股。实时行情、期权链、美债曲线都是按美股配的。A 股和港股有覆盖,但不是重点,别指望拿它做 A 股的深度跟踪。
它离不开模型。你不给模型 key,它就只剩一套空壳。跑深度分析时,token 消耗是真实成本。
它还很年轻。八个月,28 条待办,接口还在变。想拿它当生产系统,得自己扛升级。
它的技能包有一部分衍生自 Anthropic 官方的金融插件,这一层不是它的独创。
那它到底给投研这条路添了什么。我认为是两件事。一是把数据语义统一从每个接口的私活,升级成了协议层的公共约定。二是把持久化做实了,让研究能累积,而不是每次从零开始。
这两个东西都不是提示词能解决的,也都不是给通用工具装一个插件能补上的。
值不值得用,看你想要什么。如果你想有位助手随时问两句,装个通用工具就够了,没必要碰一个 46 万行的系统。如果你想搭一套自己的投研流程,结论要能追溯、数据语义要统一、还想能自己部署,那这份实现值得拉下来读一遍。就算最后不用它,它把一个投研系统该有的层次摆给你看了。
我实测里最有意思的一处,是它把 SPX 和 ^GSPC 归成了同一个键。你做跨源数据对齐的时候,是靠人工维护对照表,还是已经在代码里统一了标识?
觉得有用的话,把这篇转给同样在搞量化的朋友。
#开源项目 #AI投研 #LangAlpha #Agent框架 #MCP #量化投研 #金融数据 #Python #自部署 #AI工具实测
本文为开源项目技术拆解,不构成投资建议。实测数据为 2026-09-19 本地运行结果,项目仍在快速迭代,接口与表现可能变化。市场有风险,请合法合规投资。
Be First to Comment