作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
文中示例仅用于技术讨论,不构成任何操作建议。
量化策略开发应以学习和技术交流为目的。
本号不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 2500 字 | 预计阅读 8 分钟,前半是我自己跑出来的数字,后半有可以直接抄的完整代码,建议先收藏。
· · ·
一、我想验证一件事
技术指标到底还有没有用?
均线、RSI、量比、波动率被写了三十年,每本入门书都在教。可我按它们做的时候,结果总差不多,有时候对,有时候错,拉长看跟没做一样。麻烦在于人工样本太小,几十笔交易说明不了什么,人又只记得蒙对的那几次。
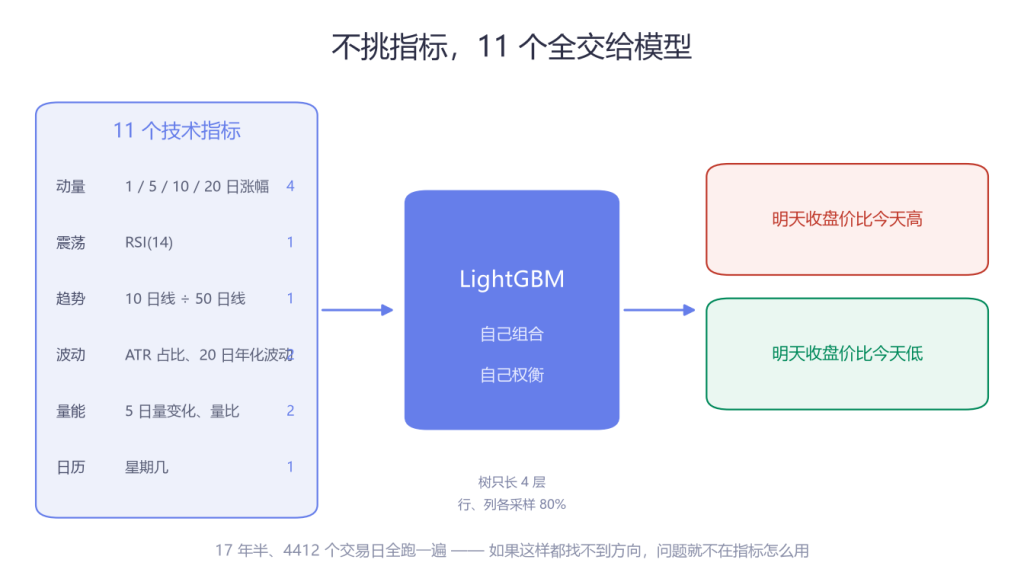
所以我换了个问法。11 个最常见的指标全喂给模型,让它自己组合、自己权衡,再把 17 年半、4412 个交易日跑一遍。如果这样都找不到方向,那问题就不在指标怎么用,而在明天往哪走本身。
做多日的方向准确率 55.35%。抛硬币是 50%,高出五个多点,是个能拿去见人的数字。但我拆开看了一遍,站不住,17 年半下来,它的总收益只有一直持有 SPY 的一半。
这是一篇讲“失败”的文章。但比“失败”更值得说的在后面。
二、模型长什么样
它只回答一个问题,明天收盘价比今天高吗。答案只有两个,涨或者跌。
喂进去的 11 个特征全从价格和成交量算出来。四个周期的动量、RSI、10 日线比 50 日线、两个波动率、两个量能,最后一个是星期几。
超参数设得很保守。树只长到 4 层,每层最多 15 个叶子,行和列各做 80% 采样。日线收益的信噪比出了名地差,配置一激进,模型就会把训练窗里的噪音背下来。
交易规则更简单,算出的上涨概率超过 53% 就持有,否则拿现金。
训练方式卡得最严,走前向验证。只用当前时间点前的数据训练,每63个交易日重新拟合一次,再拿63天做测试,模型永远看不到它要判断的那一天。
这是基本功,但市面上大部分AI交易机器人的演示不会做,它们给你看的曲线是模型在见过答案的数据上跑出来的。
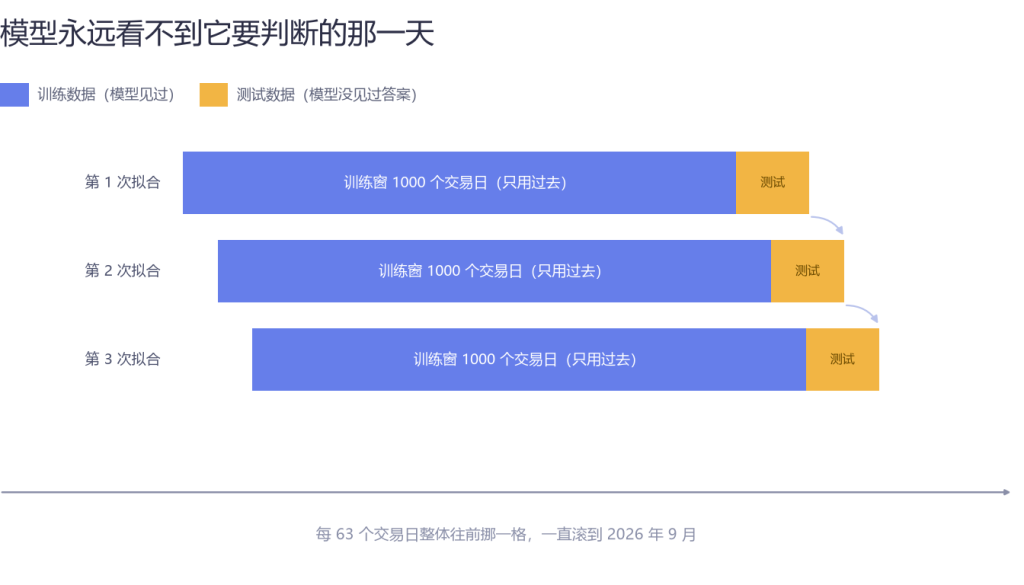
走前向验证。训练窗整体往前推,测试段永远跟在后面,模型碰不到未来的数据
三、55.35% 这个数,经不起拆
数据取 SPY 日线,未复权,6414 根。评估区间 2009-03-02 到 2026-09-15,4412 个交易日。
| 指标 | 本文实测 |
|---|---|
| 做多日方向准确率 | 55.35% |
| 在场时间占比 | 59.5% |
| 年化收益 | 10.27% |
| 最大回撤 | −30.94% |
| 夏普 | 0.76 |
| 区间总收益 | +453.98% |
| 同期一直持有 SPY | +968.06% |
先看好的一面。59.5% 的时间在场,回撤−30.94%,比一直持有的−34.10% 浅了3.16个百分点。但账放一起算就不对,年化比一直持有低4.22个百分点。
真正关键的是下一个问题。SPY 自己什么都不做,上涨的日子占多少。
我按两个口径算了一遍。今天收盘比昨天收盘高,是 54.99%;比今天开盘高,是 54.47%。模型的 55.35%,比第一个高 0.37 个百分点,比第二个高 0.89 个百分点。
0.37 个百分点是什么概念。2625 个做多日,这个样本量下标准误约 0.97 个百分点,0.37 还不到半个标准差,p 值在 0.7 附近,换个随机种子就能盖过去。
统计上这叫不显著,你没法把它和什么都没有区分开。
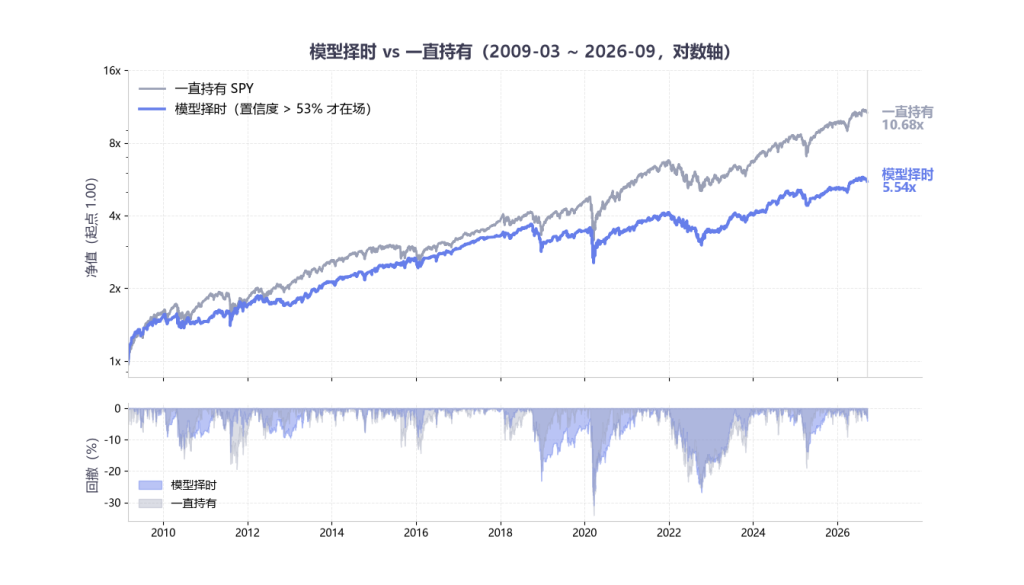
实测结果。紫线是模型择时,灰线是一直持有 SPY。模型净值 5.54 倍,一直持有 10.68 倍
四、能一锤定音的是校准
那怎么分清一个模型是真有信号,还是纯蹭基准率。
有个很干净的检验,叫校准。如果模型真有判断力,它越有把握的时候就该越准。
我把评估期每一天的输出概率拿出来,按门槛从 50% 提到 68%,看门槛以上那批日子的实际正确率。
结果是一条横线。门槛 50% 时正确率 55.06%,53% 时 55.35%,再往上走开始掉,65% 只剩 54.18%,68% 是 53.95%。
真有信号的模型,这条线该往上走。这里是一条平的线,最高置信的那批日子甚至更差。
为什么,看概率分布就明白。模型给出的上涨概率全堆在 0.5 附近,均值 0.5478,标准差只有 0.108,31.4% 的日子落在 0.45 到 0.55 之间。它既不是很有把握地对,也不是很有把握地错,就是不知道。
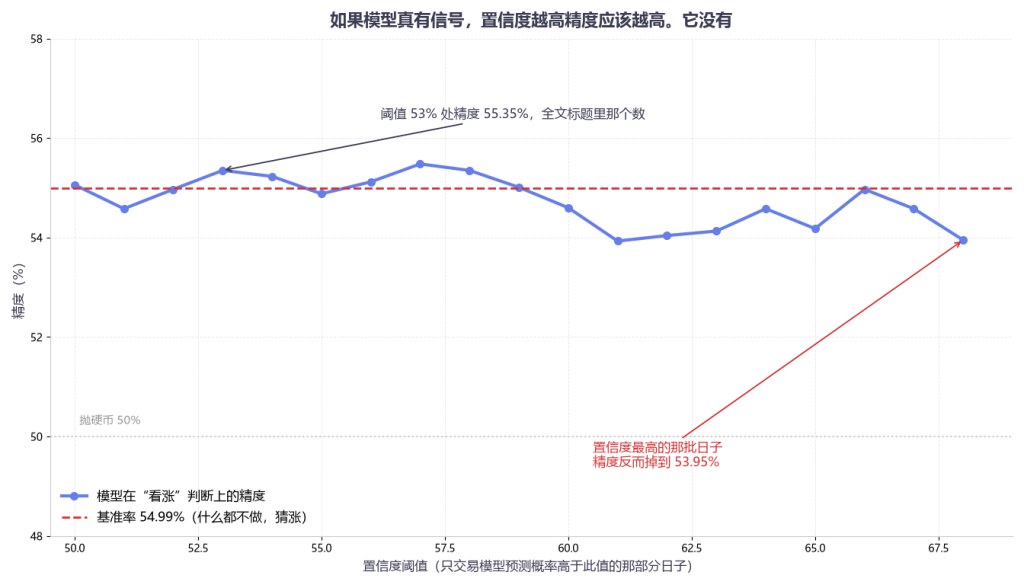
校准曲线。横轴是门槛,纵轴是实际正确率,红线是 54.99% 的基准率。整条线绕着它上下摆
五、我又补了几组对照
结论到这里已经清楚。为了堵死数据没选好这条路,我又加了几组。
第一组,把答案打乱。 训练之前,我把目标列整列随机洗牌,跑完全相同的流程,模型手上没有任何可学信息。跑三遍,做多日的准确率分别是 55.15%、54.78%、54.25%,平均 54.73%,真模型 55.35%,差 0.62 个百分点。这说明 55% 这个量级根本不来自模型。标普这 17 年本来就是涨的日子多,模型只要多数时候说涨,就能拿到这个分数。
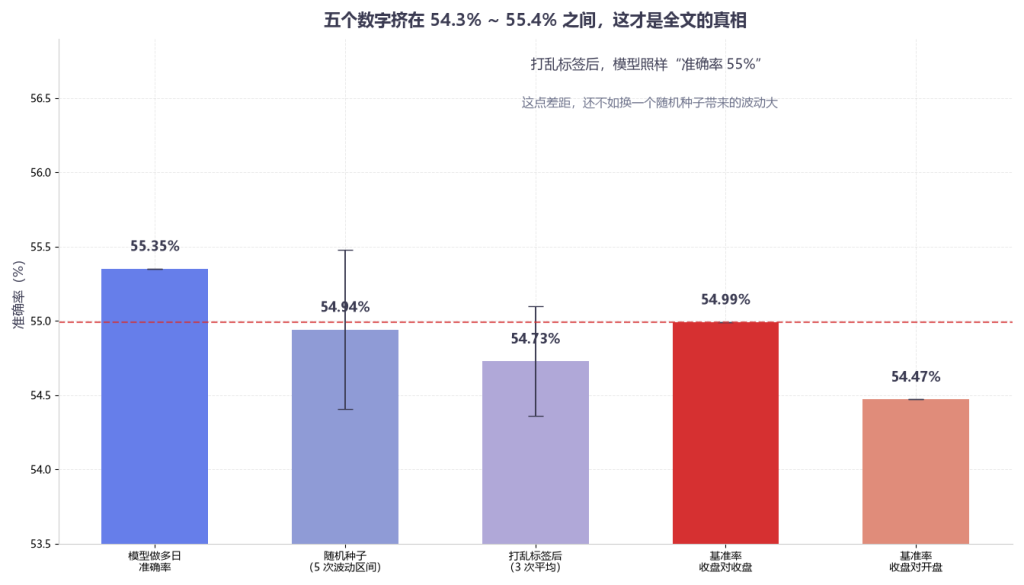
左边是模型,中间是换种子和打乱标签,右边是基准率。全部挤在 54.5% 到 55.6% 之间
第二组,把进出场的日子换成随机。 把信号换成随机数,保持同样的 59.5% 在场比例跑 200 次。区间总收益中位数 +302.85%,模型排在 84 分位;最大回撤中位数 −28.14%,比模型的 −30.94% 还浅。第三节那 3.16 个百分点的回撤改善,到这里解释清楚了,它来自仓位降低,不是判断力。
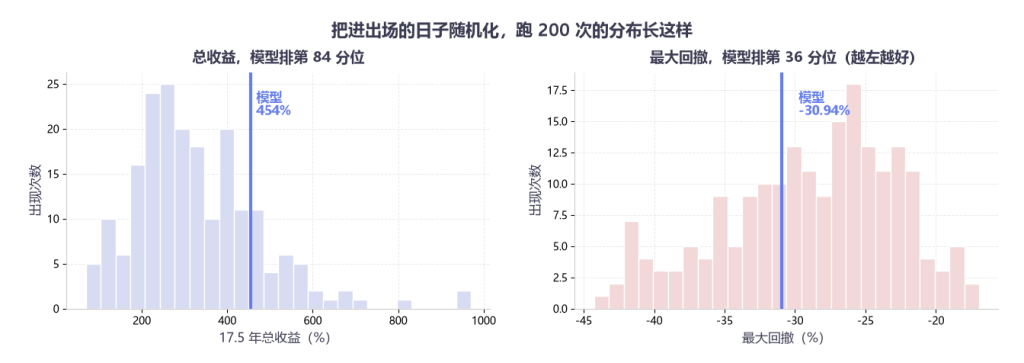
随机进出场跑 200 次,蓝线是模型的位置
还有三组。 只改随机种子跑五遍,区间总收益从 +200.90% 拉到 +453.98%,跨度 253 个百分点。整段数据一次喂进去,模型在同一样本上判断能到 63.17%,比样本外高 7.82 个百分点。加上每年 89.7 次换手和 0.02% 成本,总收益掉到 +304.72%。好看的那部分都是假的。
六、动手区,把校准检查写成代码
以上是结论。下面是能直接照做的实现,四个函数。
第一步,造 11 个特征。
FEATURE_COLS = [
    'ret1', 'ret5', 'ret10', 'ret20', 'rsi14', 'ma_ratio',
    'atr_pct', 'vol20', 'vol_change', 'vol_ratio', 'dow',
]


def build_features(df):
    df['ret1'] = df['Close'].pct_change(1)
    df['ret5'] = df['Close'].pct_change(5)
    df['ret10'] = df['Close'].pct_change(10)
    df['ret20'] = df['Close'].pct_change(20)

    delta = df['Close'].diff()
    gain = delta.clip(lower=0)
    loss = -delta.clip(upper=0)
    avg_gain = gain.ewm(alpha=1 / 14, min_periods=14).mean()
    avg_loss = loss.ewm(alpha=1 / 14, min_periods=14).mean()
    df['rsi14'] = 100 - (100 / (1 + avg_gain / avg_loss))

    df['ma_ratio'] = df['Close'].rolling(10).mean() / df['Close'].rolling(50).mean() - 1

    tr = pd.concat([
        df['High'] - df['Low'],
        (df['High'] - df['Close'].shift()).abs(),
        (df['Low'] - df['Close'].shift()).abs(),
    ], axis=1).max(axis=1)
    df['atr_pct'] = tr.rolling(14).mean() / df['Close']

    df['vol20'] = df['ret1'].rolling(20).std() * np.sqrt(252)
    df['vol_change'] = df['Volume'].pct_change(5)
    df['vol_ratio'] = df['Volume'] / df['Volume'].rolling(20).mean()
    df['dow'] = df.index.dayofweek

    df['target'] = (df['Close'].shift(-1) > df['Close']).astype(int)
    df['fwd_ret'] = df['Close'].shift(-1) / df['Close'] - 1
    return df
第二步,走前向验证跑出概率。 这段是全文最重要的代码,注意 `train` 永远只取 `i` 之前的行。
def walk_forward(df, train_window=1000, refit_every=63, seed=42):
    prob = np.full(len(df), np.nan)
    i = train_window

    while i < len(df):
        train = df.iloc[i - train_window:i]
        model = lgb.LGBMClassifier(
            n_estimators=100,
            max_depth=4,
            learning_rate=0.05,
            num_leaves=15,
            min_child_samples=30,
            subsample=0.8,
            colsample_bytree=0.8,
            random_state=seed,
            verbose=-1,
        )
        model.fit(train[FEATURE_COLS], train['target'])

        end = min(i + refit_every, len(df))
        prob[i:end] = model.predict_proba(df.iloc[i:end][FEATURE_COLS])[:, 1]
        i = end

    return prob
第三步,校准检查。 好模型的精度该随门槛抬高而明显上升,跑出来是平的,后面的绩效表就不用看了。
def calibration_check(df, thresholds=np.arange(0.50, 0.681, 0.01)):
    base_rate = df['target'].mean()          # 无条件基准率
    print(f"基准率 {base_rate:.2%}")

    for th in thresholds:
        sub = df[df['pred_prob'] > th]
        if len(sub) < 20:
            continue
        print(f"门槛 {th:.2f}  样本 {len(sub):5d}  精度 {sub['target'].mean():.2%}")
第四步,打乱标签。 这一步争议最少,也最能说服人。跑三次如果和真模型的数字差不多,说明你那个准确率跟模型的能力没关系。
def shuffled_label_test(df, n_runs=3):
    for k in range(n_runs):
        y = np.random.default_rng(k).permutation(df['target'].values)
        prob = walk_forward_with_y(df, y)
        sub = df[prob > 0.53]
        print(f"第 {k + 1} 次  做多日准确率 {sub['target'].mean():.2%}")
第五步,完整脚本,复制就能跑。 前面四段拼起来就是完整实现,第二次运行不再联网。
# -*- coding: utf-8 -*-

"""
LightGBM 日线方向模型,完整可运行版本。
数据源  akshare 新浪美股 SPY 日线(未复权,首次运行会联网下载并缓存)
流程    11 个技术特征 -> walk-forward 滚动训练 -> 概率门槛择时 -> 校准检查 -> 成本敏感性
输出    绩效对照表、校准曲线数据、特征重要性
"""

import os

import numpy as np
import pandas as pd
import akshare as ak
from lightgbm import LGBMClassifier

FEATURE_COLS = [
    'ret1', 'ret5', 'ret10', 'ret20', 'rsi14', 'ma_ratio',
    'atr_pct', 'vol20', 'vol_change', 'vol_ratio', 'dow',
]

TRAIN_WINDOW = 1000     # 用过去约 4 年的日线做训练
REFIT_EVERY = 63        # 每 63 个交易日重新拟合一次
PROB_THRESHOLD = 0.53   # 概率超过 53% 才持有,否则空仓
EVAL_START = '2009-03-01'
CACHE = 'spy_daily_cache.csv'


def load_data():
    """取 SPY 日线。第一次联网下载,之后走本地缓存。"""
    if os.path.exists(CACHE):
        df = pd.read_csv(CACHE, parse_dates=['date'])
    else:
        df = ak.stock_us_daily(symbol='SPY')
        df['date'] = pd.to_datetime(df['date'])
        df.to_csv(CACHE, index=False)

    df = df.rename(columns={
        'open': 'Open', 'high': 'High',
        'low': 'Low', 'close': 'Close', 'volume': 'Volume',
    })
    return df.set_index('date').sort_index()


def build_features(df):
    """把原始 OHLCV 变成 11 个特征,外加目标列和次日收益。"""
    df = df.copy()
    df['ret1'] = df['Close'].pct_change(1)
    df['ret5'] = df['Close'].pct_change(5)
    df['ret10'] = df['Close'].pct_change(10)
    df['ret20'] = df['Close'].pct_change(20)

    delta = df['Close'].diff()
    gain = delta.clip(lower=0)
    loss = -delta.clip(upper=0)
    avg_gain = gain.ewm(alpha=1 / 14, min_periods=14).mean()
    avg_loss = loss.ewm(alpha=1 / 14, min_periods=14).mean()
    df['rsi14'] = 100 - (100 / (1 + avg_gain / avg_loss))

    df['ma_ratio'] = df['Close'].rolling(10).mean() / df['Close'].rolling(50).mean() - 1

    tr = pd.concat([
        df['High'] - df['Low'],
        (df['High'] - df['Close'].shift()).abs(),
        (df['Low'] - df['Close'].shift()).abs(),
    ], axis=1).max(axis=1)
    df['atr_pct'] = tr.rolling(14).mean() / df['Close']

    df['vol20'] = df['ret1'].rolling(20).std() * np.sqrt(252)
    df['vol_change'] = df['Volume'].pct_change(5)
    df['vol_ratio'] = df['Volume'] / df['Volume'].rolling(20).mean()
    df['dow'] = df.index.dayofweek

    df['target'] = (df['Close'].shift(-1) > df['Close']).astype(int)
    df['fwd_ret'] = df['Close'].shift(-1) / df['Close'] - 1
    return df.dropna(subset=FEATURE_COLS + ['target'])


def walk_forward(df, seed=42, train_window=TRAIN_WINDOW, refit_every=REFIT_EVERY):
    """滚动训练并输出每一天的上涨概率。训练集永远只用当天之前的数据。"""
    prob = np.full(len(df), np.nan)
    importances = []
    i = train_window

    while i < len(df):
        train = df.iloc[i - train_window:i]
        model = LGBMClassifier(
            n_estimators=100, max_depth=4, learning_rate=0.05,
            num_leaves=15, min_child_samples=30,
            subsample=0.8, colsample_bytree=0.8,
            random_state=seed, verbose=-1,
        )
        model.fit(train[FEATURE_COLS], train['target'])

        end = min(i + refit_every, len(df))
        prob[i:end] = model.predict_proba(df.iloc[i:end][FEATURE_COLS])[:, 1]
        importances.append(pd.Series(model.feature_importances_, index=FEATURE_COLS))
        i = end

    return prob, importances


def stats(ret):
    """把日收益序列换算成年化、回撤、夏普。"""
    ret = ret.dropna()
    nav = (1 + ret).cumprod()
    years = len(ret) / 252
    cagr = nav.iloc[-1] ** (1 / years) - 1
    mdd = (nav / nav.cummax() - 1).min()
    sharpe = ret.mean() / ret.std() * np.sqrt(252)
    return dict(
        总收益=f"{nav.iloc[-1] - 1:.2%}",
        年化=f"{cagr:.2%}",
        最大回撤=f"{mdd:.2%}",
        夏普=f"{sharpe:.2f}",
    )


def main():
    df = build_features(load_data())
    start = max(int(df.index.searchsorted(pd.Timestamp(EVAL_START))), TRAIN_WINDOW)
    prob, imps = walk_forward(df, seed=42)

    ev = df.iloc[start:].copy()
    ev['prob'] = prob[start:]
    ev = ev.dropna(subset=['prob', 'fwd_ret'])
    ev['signal'] = (ev['prob'] > PROB_THRESHOLD).astype(int)
    print(f"样本 {ev.index[0].date()} ~ {ev.index[-1].date()},{len(ev)} 个交易日")

    # 1 基准率与准确率
    base = ev['target'].mean()
    acc = ev.loc[ev['signal'] == 1, 'target'].mean()
    print(f"\n无条件上涨日占比 {base:.2%}")
    print(f"模型做多日准确率 {acc:.2%},超额 {(acc - base) * 100:.2f} 个百分点")
    print(f"在场时间占比 {ev['signal'].mean():.1%}")

    # 2 绩效对照
    print("\n模型择时", stats(ev['signal'] * ev['fwd_ret']))
    print("一直持有", stats(ev['fwd_ret']))

    # 3 校准检查,这一步决定要不要继续看下去
    print("\n门槛   样本   精度")
    for th in np.arange(0.50, 0.681, 0.01):
        sub = ev[ev['prob'] > th]
        if len(sub) >= 20:
            print(f"{th:.2f}  {len(sub):5d}  {sub['target'].mean():.2%}")

    # 4 特征重要性
    imp = pd.concat(imps, axis=1).mean(axis=1).sort_values(ascending=False)
    print("\n特征重要性(季度重训均值)")
    print(imp.round(1).to_string())

    # 5 成本敏感性,每年换手约 89 次
    turn = ev['signal'].diff().abs().fillna(0)
    print(f"\n每年换手 {turn.sum() / (len(ev) / 252):.1f} 次")
    for cost in [0, 0.0001, 0.0002, 0.0005]:
        print(f"单边成本 {cost:.2%}", stats(ev['signal'] * ev['fwd_ret'] - turn * cost))


if __name__ == '__main__':
    main()
七、到底学到了什么
有一点得说清,模型不是在乱来。
我把 71 次季度重训的特征重要性存下来,统计每个特征进当季前三名的频率。最高的是量比 61.6%,昨日涨幅 52.3%,5 日涨幅 34.9%,星期几从来没进过前三,0%。
它确实抓到了数据里真实存在的结构,比如波动率的聚集、量价之间的联动。这些结构客观存在,随便什么模型都能找到,只是不指向明天。
它学会了哪些特征之间有关系,没学会明天往哪走。这两件事听起来接近,实际差得很远。
换更长的周期、换横截面、换另类数据,都是方向,不是承诺。谁说换个输入就能跑赢,让他先把校准曲线放出来。
八、观点总结
回到最开始那个问题。技术指标还有没有用。
我发现自己原来的问法是歪的。指标有没有用是表面问题,我真正想问的是:能不能靠它们猜准明天。这两件事不是一回事。
指标有用。它们能告诉你过去发生了什么、现在的波动比上个月大还是小,也能让你面对同一个位置时保持一致。
明天收盘比今天高吗?这个问题,价格和成交量回答不了。11 个指标不行,换 20 个也不行;LightGBM 不行,更深的网络大概率也不行。不是模型不够聪明,是这个问题能用的信息本来就这么少。
想通这一点,大家应该反而踏实了。以前总觉得做不出稳定的模型是自己不够努力,参数没调好、特征没造全、数据没找对。现在知道不是。
那个模型我没删,留在文件夹里。净值曲线跑输一直持有,校准曲线是一条平的线,都不算光彩。但它拦住了一个念头,那个再努力一点就能猜准的念头。
这篇就到这。如果你手上也有一个准确率还不错的模型,我想请你做一件事,在它的准确率旁边写上市场的基准率。两个数字放一起,它值多少就清楚了。
#机器学习 #LightGBM #量化交易 #SPY #技术指标 #回测 #过拟合 #校准曲线 #基准率 #量化研究 #Python #模型评估
Be First to Comment