作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
文中示例仅用于技术讨论,不构成任何操作建议。
量化策略开发应以学习和技术交流为目的。
本号不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 3400 字,另有 6 段可运行代码 | 预计阅读 12 分钟。前半是介绍、安装和用法,后半有完整复算过程和代码,建议先收藏。
· · ·
GitHub 上有个开源量化组织,叫 QuantSkills,内容可以说是包罗万象。
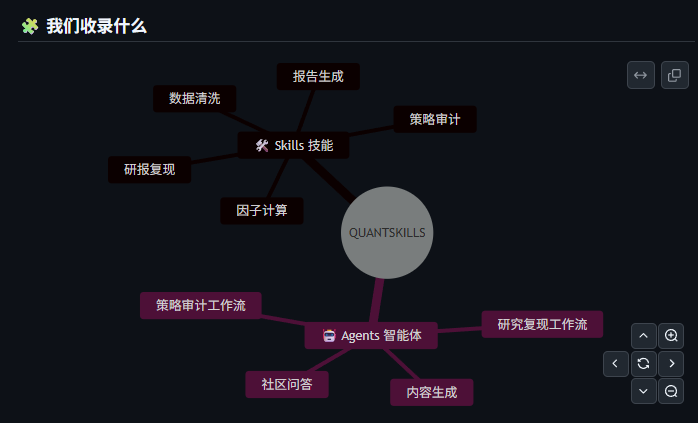
我在这个社区挖掘了一些高价值的内容,这次给大家分享的就是【因子计算】的相关内容。它把 800 个选股因子打包成了 AI 助手能直接调用的技能包,每个因子一个文件夹,公式、代码、验证报告配齐,GPLv3 开源,不收钱。
最特别的就是那份验证报告。IC、ICIR、分组收益、换手率,一样不缺,规格看上去直逼券商金工研报。开源圈里肯把验证做成标准件的,我见得不多。
我把其中一个库的 216 份报告全部下载下来汇总了一遍,又用 793 只 A 股把四个代表因子重新算了一遍。这篇文章分两半。前半讲这套东西是什么、怎么装、怎么用,不动代码也能搞完。后半是我复算的全过程和代码,想自己验证接着往下看。
一、这是个什么东西
一句话,它只算因子值,别的一概不管。
这三个因子库不调用大模型,不联网,不读任何 API key。输入只要六列行情数据。
date, symbol, open, high, low, close, volume日期、股票代码、开高低收、成交量。你把自己的行情整理成长表喂进去,它返回一列因子值。数据完全由使用者负责,仓库里连一份真实行情都不带,只放了 toy data。
组织下最重的资产是三个因子库。
| 仓库 | 因子数 | 覆盖方向 |
|---|---|---|
| directional-alpha | 296 | 趋势 148、动量 50、突破 48、反转 25、通道 25 |
| risk-pattern-alpha | 288 | 波动率、K 线形态、震荡、回撤 |
| volume-stat-alpha | 216 | 成交量 48、量价 48、时序排名 48、收益分布 48、流动性 24 |
三个加起来 800。所以我标题”800 个因子”这个说法,数字是真的。
每个因子是一个独立文件夹,长这样。
factors/
  R020-5d-z-scored-volume-expansion/
    SKILL.md               给 AI 助手读的说明
    scripts/factor.py      因子公式的实现
    references/formula.md  数学定义
    scripts/validate.py    自检脚本
    validation_real/       验证报告
SKILL.md 是给 AI 助手读的说明,factor.py 是公式实现,formula.md 是数学定义,validate.py 是自检脚本,validation_real/ 放验证报告。结构很干净。
第一次用的时候我是非常认可这种方式的,觉得终于有人把验证做成了标准件,而不是甩一句”回测通过”就完事。
有个细节值得留意。目录页仓库拿了 1975 个星,真正装因子的三个库加起来 28 个。收藏的门槛是三十秒,使用的门槛是半天,星标量的永远是前者。这个反差,后面还会用到。
二、我实测的结果,先给答案
两件事。第一件,把 volume-stat 库 216 个因子的验证报告全下载,汇总。第二件,用我自己的数据把其中四个重新算一遍。
选的四个是R020、216 个里公布 IC 最高的 R684、中位附近的 R459、最低的 R617。
| 因子 | 公布IC | 我的IC | 公布多空 | 我的多空 | 公布换手 | 我的换手 |
|---|---|---|---|---|---|---|
| R020 | +0.0037 | -0.0055 | +0.073% | -0.066% | 0.704 | 0.692 |
| R684 | +0.0166 | -0.0032 | +0.211% | +0.070% | 0.205 | 0.175 |
| R459 | +0.0018 | -0.0108 | +0.059% | -0.014% | 0.514 | 0.505 |
| R617 | -0.0278 | -0.0220 | +0.006% | -0.008% | 0.172 | 0.141 |
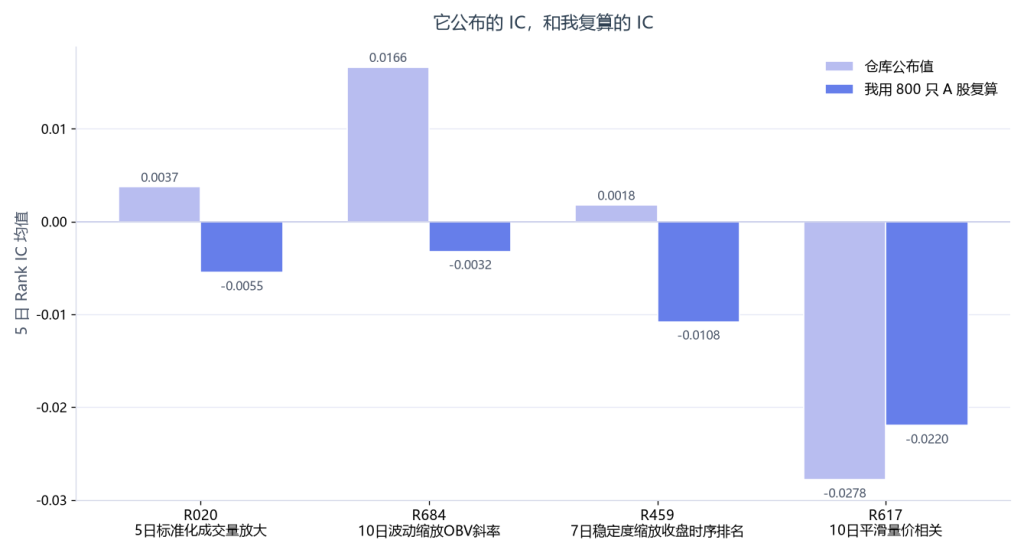
四个因子,公布值与我复算值的对照
看表之前先花二十秒讲清 Rank IC:每天把所有股票按因子值排一次队,再按它们未来五天的实际涨幅排一次队,看两次排队像不像。完全一样是 1,毫无关系是 0。业内经验门槛在 0.02 到 0.03,能稳定做到 0.05 的已经是生产级水平。
结果三条。
第一条,换手率那一列几乎完美对上。0.704 对 0.692,0.205 对 0.175,0.514 对 0.505。换手率由因子值和股票池共同决定,它这么接近,说明我的数据管道和它的公式口径一致,我算的不是另一套东西。
第二条,IC 那一列四个里三个符号翻转。公布值最高的 R684,在我这份数据上跑出来是负的。
第三条,我拿一串纯随机数当因子跑了一遍,IC 0.0005,t 值 0.48,落在 216 个因子的中位附近。这批因子作为一个整体,对后续涨跌的区分能力和随机数在同一个量级。
而 216 个因子,全部标注 pass。
pass 到底验了什么,后半讲。先把安装和用法说完。
三、怎么装
三步,五分钟。
第一步拿代码。git clone --depth 1 https://github.com/quantskills/skill-quant-factor-volume-stat-alpha.git。仓库不大,两百多个因子文件夹,几秒钟下完。
第二步装依赖。整个仓库只要三个包,pip install numpy pandas pyarrow。没有 API key,没有数据平台 SDK,这一条是真心省事。
第三步备数据。准备一个长表 CSV,每行是一只股票在一个交易日的记录,六列,列名照第一节的来。数据从哪来都行,akshare 的免费接口就能拉,拉取脚本在文末。
四、装好之后怎么用
每个因子的 compute_factor 是独立函数,动态导入就能跑,不用装成包。
import importlib.util
import sys
from pathlib import Path


def load_factor(factor_dir):
    """从因子目录里动态载入 factor.py。"""
    path = Path(factor_dir) / "scripts" / "factor.py"
    spec = importlib.util.spec_from_file_location("factor_module", path)
    module = importlib.util.module_from_spec(spec)
    sys.modules[spec.name] = module
    spec.loader.exec_module(module)
    return module


mod = load_factor("skill-quant-factor-volume-stat-alpha/factors/R020-5d-z-scored-volume-expansion")
panel = mod.compute_factor(panel)
col = mod.FACTOR_COLUMN
跑完 panel 里会多一列,列名就是因子短名,比如 5d-z-scored-volume-expansion。这一列就是每天的因子值,拿去排序、分组、筛股都行。
一句话定位。公式它写好了,结构它搭好了,数据要你自己接,判断要你自己做。
以上是普通读者的部分,装上就能用。往下是动手部分,写给想自己算 IC、想验证那些报告的人。
五、216 份报告的真面目
先把汇总表放出来。
| 指标 | 数值 |
|---|---|
| 5 日 Rank IC 中位数 | 0.001765 |
| 绝对值小于 0.01 的因子 | 189 / 216 |
| 绝对值大于等于 0.03 的因子 | 0 |
| 5 日 ICIR 中位数 | 0.0851 |
| 多空组合 5 日价差中位数 | 0.058% |
| 多空价差小于等于 0 的因子 | 35 / 216 |
| Top 组 5 日换手率中位数 | 53.6% |
| 标注 pass 的因子 | 216 / 216 |
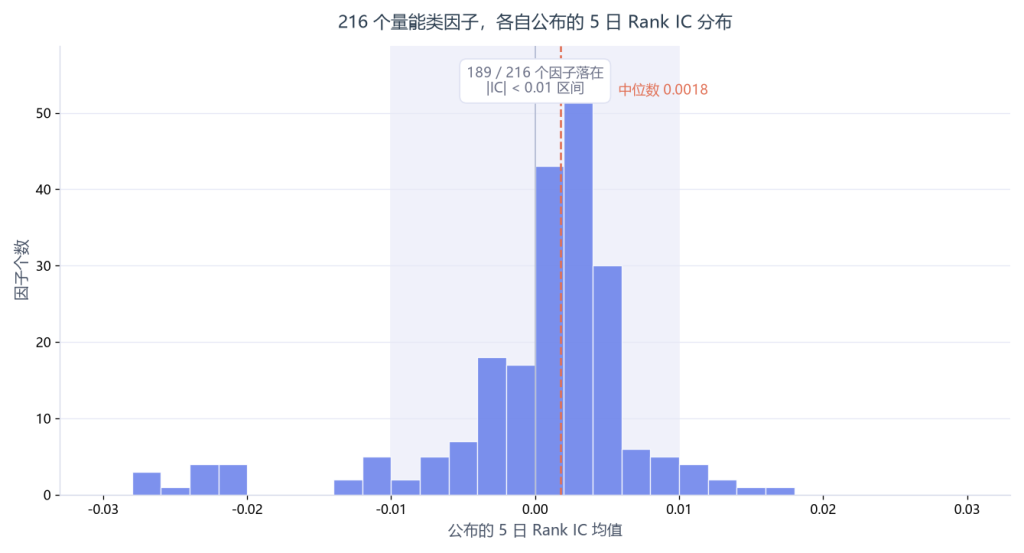
216 个因子的 5 日 Rank IC 分布,189 个落在正负 0.01 之间
Rank IC 中位数 0.0018。189 个因子的绝对值不到 0.01,没有一个摸到 0.03。而全表 216 个,全部写着 pass。
这个 pass 是怎么验出来的。我打开 validate.py,全文 53 行。它做四件事,用 np.random.default_rng(11) 生成 12 只股票、180 个交易日的随机游走数据,跑一遍公式,断言结果里存在有限值,打印一行 status ok。
没有 IC,没有分组收益。它的判定条件是代码跑起来了,没崩,也没吐出 NaN。
那报告里那些 IC 数字从哪来。report.md 最后一行写了,由 real_market_data/ 目录里的缓存真实行情计算得到。我把整个仓库翻了一遍,868 个 Markdown、432 个 Python、219 个 JSON,没有这个目录。它在自己的 .gitignore 里。
所以现状是,数字公布了,但复算不了。
六、动手区,自己算 IC 的二十行代码
想知道一个因子有没有用,别看标签,自己跑。两段代码。
第一段拉数据。免费建议用akshare 的新浪源,东财源在批量请求下会被限流,实测十次全部失败,新浪源十次全过。
import akshare as ak
import pandas as pd


def load_panel(codes, start="20211201", end="20260911"):
    """把股票代码列表拉成长表。新浪源比东财源稳,批量请求下东财会限流。"""
    frames = []
    for code in codes:
        prefix = "sh" if code.startswith(("6", "9")) else "sz"
        df = ak.stock_zh_a_daily(
            symbol=prefix + code, start_date=start, end_date=end, adjust="qfq"
        )
        if df is None or len(df) < 250:
            continue
        df = df[["date", "open", "high", "low", "close", "volume"]].copy()
        df["symbol"] = code
        frames.append(df)

    panel = pd.concat(frames, ignore_index=True)
    panel["date"] = pd.to_datetime(panel["date"])
    return panel
第二段算指标。横截面 Spearman 相关加五分组,和仓库报告的口径对齐。
import numpy as np


def evaluate(panel, col, horizon=5, cost=0.003):
    """算 5 日 Rank IC、ICIR、五分组多空价差、Top 组换手率,再扣一次成本。"""
    d = panel.sort_values(["symbol", "date"]).copy()
    d["fwd"] = d.groupby("symbol")["close"].shift(-horizon) / d["close"] - 1

    def one_day(g):
        g = g.dropna(subset=[col, "fwd"])
        if len(g) < 30 or g[col].nunique() < 5:
            return np.nan
        return g[col].corr(g["fwd"], method="spearman")

    ic = d.groupby("date").apply(one_day, include_groups=False).dropna()

    spreads, turnovers, prev = [], [], set()
    for _, g in d.groupby("date"):
        g = g.dropna(subset=[col, "fwd"])
        if len(g) < 30:
            continue

        q = pd.qcut(g[col].rank(method="first"), 5, labels=False)
        top, bot = g.loc[q == 4], g.loc[q == 0]
        spreads.append(top["fwd"].mean() - bot["fwd"].mean())

        cur = set(top["symbol"])
        if prev:
            turnovers.append(1 - len(prev & cur) / len(prev))
        prev = cur

    ls = float(np.mean(spreads))
    to = float(np.mean(turnovers))

    return {
        "ic": float(ic.mean()),
        "icir": float(ic.mean() / ic.std(ddof=0)),
        "t": float(ic.mean() / ic.std(ddof=0) * np.sqrt(len(ic))),
        "observations": int(len(ic)),
        "long_short": ls,
        "turnover": to,
        "net": ls - to * cost,
}跑出来六个数字,ic、icir、t、long_short、turnover、net。任何一份因子报告,只要它没告诉你样本区间和股票池,你拿这段代码跑一遍,就能把话问清楚。
七、换手率对上了,IC 翻了向
第二节那张表,值得展开讲的是两层。
换手率那层,几乎逐位复现。这证明的不是因子好,是我的管线和它的口径一致。所以后面 IC 上的差异,不能推给”我算错了”。
IC 那层,四个里三个符号翻转。R020 由正的 0.0037 转为负的 0.0055。R459 由正的 0.0018 转为负的 0.0108。R684 更彻底,它是 216 个里 IC 最高的,公布 0.0166,我这份数据上跑出来是负的 0.0032。
为了让这个结论站得住,我先做了方向性自检。5 日反转因子 IC 正的 0.0128,t 值 2.43。20 日动量 IC 负的 0.0287,t 值 -4.96。两个方向都符合 A 股短周期特征,说明我的管线没搞反。随机数那组在第二节说过了,IC 0.0005,落在因子们的中位附近。
四个里唯一方向一致的是 R617,公布 -0.0278,我算出 -0.0220,t 值 -6.09,是唯一统计显著的。但这个显著性吃不到钱。它的多空价差只有 -0.008%,反过来用也只有 0.008%,不到交易成本的四分之一。
IC 显著和能赚钱,中间隔着好几道墙。
再算一步它没算的
仓库报告里没有成本这一项。我补上。按每单位换手 0.30% 估算往返成本,佣金双边、印花税单边、再加滑点,这个数对大中盘股算客气。
| 因子 | 多空价差 | 估算成本 | 净额 | 折年化 |
|---|---|---|---|---|
| R020 | -0.066% | 0.208% | -0.274% | 约 -13.3% |
| R684 | +0.070% | 0.053% | +0.017% | 约 +0.8% |
| R459 | -0.014% | 0.151% | -0.166% | 约 -8.1% |
| R617 | -0.008% | 0.042% | -0.050% | 约 -2.4% |
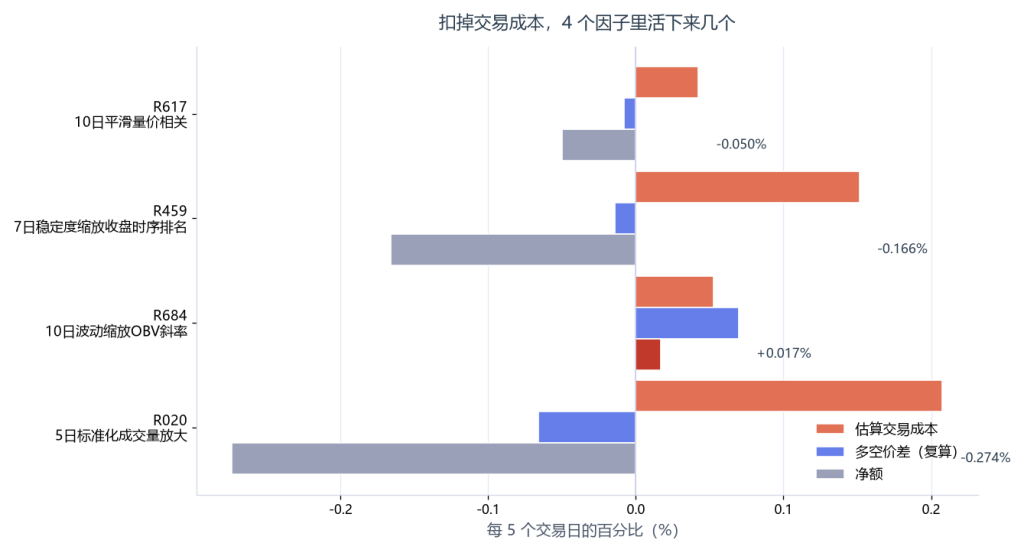
扣掉换手成本前后的多空价差,三色对照
四个里三个扣完成本是负的。R020 最典型,多空价差本身已经是负的,还要再付 0.208% 的换手成本,因为它每五天换掉将近七成仓位。唯一为正的 R684,年化 0.8%,而它的 t 值 -0.78,落在噪音里。
到这一步,216 份报告里 pass 这个词的分量,大概能掂出来了。照它的标签挑因子,你会挑到 R684,216 个里 IC 最高的那个。它在我这份数据上 IC 是负的,扣完成本年化 0.8%。
800 的构成,其实是 9 乘 24
翻到仓库根目录,有个文件叫 repo_summary.json,里面有一行 bases 分布,把 216 个因子按基础公式归类。volume_ratio、volume_z、dollar_volume、price_volume_corr、obv_slope、ts_rank_close、ts_rank_volume、ret_skew、ret_kurt,9 个公式,每个 24 个变体,正好 216。
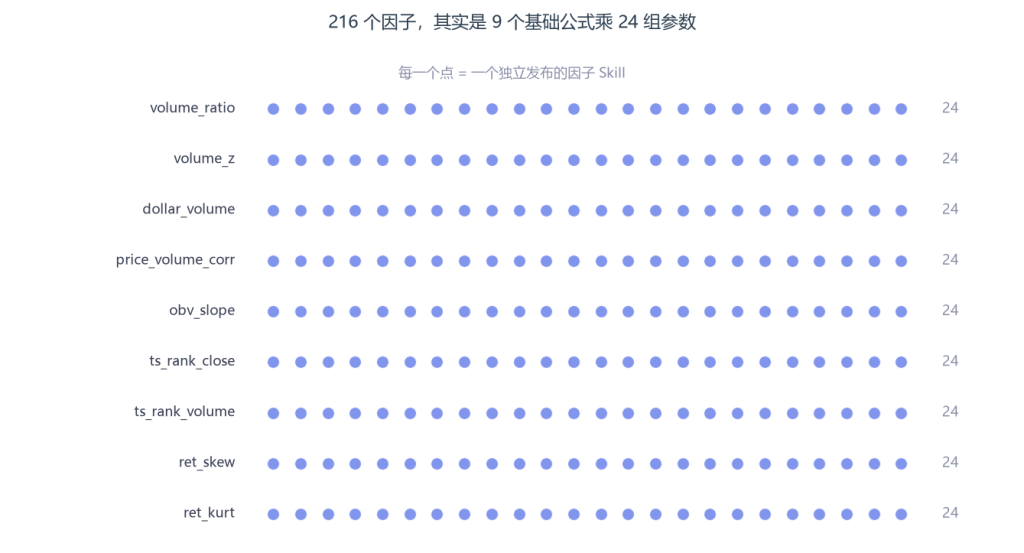
800 个因子的构成,9 个基础公式 × 24 组参数
24 个变体是同一个公式换窗口和换变换得来的。以 R020 为例,定义是 z(volume_ratio, window=5),五日量比再做滚动标准化。窗口换成 7、换成 10,标准化换成平滑、换成时序排名、换成波动缩放,就是另外十几个因子。
所以 800 的准确读法是,十几个想法乘上参数网格。
参数扫描本身是标准动作,不算罪状。但它改变了一件事的读法。同一族里的 24 个变体表现必然高度相关,一个通过,一整片跟着通过,216 个全 pass 几乎是被结构决定的。更关键的是,试了 216 个组合总有几个看起来不错,这份报告里没有 DSR,没有 PBO,也没有任何一处提到试了多少个才挑出这些。
有点讽刺。这个组织的资产目录里就躺着干这个的 skill,skill-backtest-overfit 用 DSR 和 PBO 评估回测过拟合。工具都在,因子库自己没用。
八、那这套东西还值不值得花时间看
值得,但要看对地方。
值得抄的三样。
一是因子目录的结构。五个位置把”一个因子该交代什么”固定下来,比绝大多数个人研究者的文件夹规范,可以直接搬回自己的因子库。
二是验证指标的清单。覆盖率、5 日 Rank IC、5 日 ICIR、五分组价差、Top 组换手率、无未来函数检查,六项选得贴地气,尤其换手率,很多报告干脆不写。
三是”数据由使用者提供”这个边界。它逼你把数据管道接上去,而不是喂你一份不知道来源的成品。
不该抄的也有三样。
标签不要抄。pass 在这批资产里的含义是代码跑通,不是因子有效,两者隔着一整套验证工作。
结论不要抄。216 个因子的 IC 中位数 0.0018,这个数字是公开的,只是没人汇总过。汇总完就不该指望从里面直接挑出能用的因子。
验证的可信度不要默认接受。一份报告里出现的数字,和一份能被复算的数字,是两种东西。前者只需要一个 print 语句,后者要把数据、股票池、区间、成本设定一并交出来。
回到那个星标数字。目录页 1975 星,三个因子库加起来 28 星。这批资产里最有价值的部分不是那 800 个因子,是那套”每个因子都该有一份交代”的形式。而它最经不起推敲的部分,也是这份交代本身。
可审计性的意思不是把数字公布出来,是别人能拿着你的数据把数字重新算一遍。做不到后半句,前半句就只是排版。
文中提到的三个因子库均为 GPLv3 开源项目。复现脚本和数据区间已在正文注明,你可以用同样方式在你自己的股票池上重跑一遍。
附,文末完整脚本
存成 repro.py,跑之前先 pip install akshare numpy pandas。首次运行会联网拉取日线,约 15 分钟,之后走本地缓存。它会依次复算文章里那四个因子,直接打出对照表。
# -*- coding: utf-8 -*-

"""
QuantSkills 因子库复算脚本。
用法:
    python repro.py

默认复算文章里那四个因子,股票池为沪深300 + 中证500 成分股。
首次运行会联网拉取日线数据,约 15 分钟,之后走本地缓存。
"""

import importlib.util
import os
import sys
import time

import akshare as ak
import numpy as np
import pandas as pd

WORK = os.path.dirname(os.path.abspath(__file__))
DATA = os.path.join(WORK, "data")
PRICES = os.path.join(DATA, "prices")
FACTOR_ROOT = os.path.join(WORK, "skill-quant-factor-volume-stat-alpha", "factors")

START = "20211201"
END = "20260911"
HORIZON = 5
COST_PER_TURNOVER = 0.0030
MIN_NAMES = 30

TARGETS = [
    "R020-5d-z-scored-volume-expansion",
    "R684-10d-volatility-scaled-obv-slope",
    "R459-7d-stability-scaled-close-ts-rank",
    "R617-10d-smoothed-price-volume-correlation",
]

INDEXES = [("000300", "沪深300"), ("000905", "中证500")]


def get_universe():
    """取沪深300和中证500成分股,返回 {代码: 交易所}。"""
    out = {}
    for code in [i[0] for i in INDEXES]:
        df = ak.index_stock_cons_csindex(symbol=code)
        for _, row in df.iterrows():
            c = str(row["成分券代码"]).zfill(6)
            out.setdefault(c, str(row.get("交易所", "") or ""))
    return out


def fetch_one(code, exch):
    """拉单只股票的前复权日线,落地成 CSV。已存在则跳过。"""
    path = os.path.join(PRICES, f"{code}.csv")
    if os.path.exists(path) and os.path.getsize(path) > 500:
        return

    prefix = "sh" if ("上海" in exch or code.startswith(("6", "9"))) else "sz"
    for attempt in range(3):
        try:
            df = ak.stock_zh_a_daily(
                symbol=prefix + code, start_date=START, end_date=END, adjust="qfq"
            )
            if df is not None and len(df) >= 250:
                df = df[["date", "open", "high", "low", "close", "volume"]].copy()
                df["symbol"] = code
                df.to_csv(path, index=False, encoding="utf-8-sig")
                return
        except Exception:
            time.sleep(0.5 * (attempt + 1))
    print(f"[warn] {code} 拉取失败,跳过")


def prepare_data():
    os.makedirs(PRICES, exist_ok=True)
    universe = get_universe()
    print(f"[data] 股票池 {len(universe)} 只,开始拉取...")
    for i, (code, exch) in enumerate(sorted(universe.items()), 1):
        fetch_one(code, exch)
        time.sleep(0.15)
        if i % 100 == 0:
            print(f"[data] {i}/{len(universe)}")


def load_panel():
    """把落地好的 CSV 读成长表。"""
    frames = []
    for name in sorted(os.listdir(PRICES)):
        if not name.endswith(".csv"):
            continue
        code = name[:-4]
        df = pd.read_csv(os.path.join(PRICES, name))
        if len(df) < 250:
            continue
        df["symbol"] = code
        frames.append(df[["date", "open", "high", "low", "close", "volume", "symbol"]])

    panel = pd.concat(frames, ignore_index=True)
    panel["date"] = pd.to_datetime(panel["date"])
    for c in ("open", "high", "low", "close", "volume"):
        panel[c] = pd.to_numeric(panel[c], errors="coerce")
    panel = panel.dropna(subset=["close", "volume"])

    print(f"[panel] {panel['symbol'].nunique()} 只股票,{len(panel)} 行,"
          f"{panel['date'].min().date()} 至 {panel['date'].max().date()}")
    return panel


def load_factor(factor_dir):
    """动态载入因子目录里的 factor.py。"""
    path = os.path.join(FACTOR_ROOT, factor_dir, "scripts", "factor.py")
    spec = importlib.util.spec_from_file_location("m_" + factor_dir.split("-")[0], path)
    module = importlib.util.module_from_spec(spec)
    sys.modules[spec.name] = module
    spec.loader.exec_module(module)
    return module


def evaluate(panel, col, horizon=HORIZON, cost=COST_PER_TURNOVER):
    """算 5 日 Rank IC、ICIR、t 值、五分组多空价差、Top 组换手率、扣成本净额。"""
    d = panel.sort_values(["symbol", "date"]).copy()
    d["fwd"] = d.groupby("symbol")["close"].shift(-horizon) / d["close"] - 1

    def one_day(g):
        g = g.dropna(subset=[col, "fwd"])
        if len(g) < MIN_NAMES or g[col].nunique() < 5:
            return np.nan
        return g[col].corr(g["fwd"], method="spearman")

    ic = d.groupby("date").apply(one_day, include_groups=False).dropna()

    spreads, turnovers, prev = [], [], set()
    for _, g in d.groupby("date"):
        g = g.dropna(subset=[col, "fwd"])
        if len(g) < MIN_NAMES:
            continue
        q = pd.qcut(g[col].rank(method="first"), 5, labels=False)
        top, bot = g.loc[q == 4], g.loc[q == 0]
        spreads.append(top["fwd"].mean() - bot["fwd"].mean())

        cur = set(top["symbol"])
        if prev:
            turnovers.append(1 - len(prev & cur) / len(prev))
        prev = cur

    ls = float(np.mean(spreads))
    to = float(np.mean(turnovers))
    std = float(ic.std(ddof=0))

    return {
        "ic": float(ic.mean()),
        "icir": float(ic.mean() / std),
        "t": float(ic.mean() / std * np.sqrt(len(ic))),
        "n": int(len(ic)),
        "long_short": ls,
        "turnover": to,
        "net": ls - to * cost,
    }


def main():
    prepare_data()
    panel = load_panel()

    rows = []
    for folder in TARGETS:
        mod = load_factor(folder)
        out = mod.compute_factor(panel.copy())
        col = mod.FACTOR_COLUMN
        r = evaluate(out, col)
        rows.append((mod.SPEC["factor_id"], mod.SPEC["name_cn"], r))
        print(f"{mod.SPEC['factor_id']}  IC={r['ic']:+.4f}  ICIR={r['icir']:+.3f}  "
              f"t={r['t']:+.2f}  多空={r['long_short'] * 100:+.4f}%  "
              f"换手={r['turnover']:.3f}  净额={r['net'] * 100:+.4f}%")

    print("\n| 因子 | IC | ICIR | t | 多空 | 换手 | 净额 |")
    print("|-|-|-|-|-|-|-|")
    for fid, name, r in rows:
        print(f"| {fid} {name} | {r['ic']:+.4f} | {r['icir']:+.3f} | {r['t']:+.2f} | "
              f"{r['long_short'] * 100:+.4f}% | {r['turnover']:.3f} | {r['net'] * 100:+.4f}% |")


if __name__ == "__main__":
    main()
跑完这张表,就是第二节那张对照表的复算侧。把 TARGETS 换成任意一个因子目录名,就能复算那一个。
一个提醒
上面脚本里 TARGETS 用的是完整文件夹名。仓库里这两百多个文件夹的命名是”编号 + 英文短名”,同一个基础公式换窗口和变换之后短名会很像,R020 和 R021 只差一个词。抄目录名之前先 ls factors/ 对一遍,写错一个词就是 FileNotFoundError,这个坑我踩过。
写在最后
我想把问题还给做因子的人,也包括我自己。
你的因子库里,有多少个是代码一跑通就当能用了。这中间那一步,你是自己算过 IC,还是看了一眼别人给的数字。
这个问题的答案,比 800 这个数字重要得多。觉得有用的话,把这篇转给同样在搞量化的朋友。文末完整脚本可以直接复制运行,默认跑文章里那四个因子。
#量化因子 #因子验证 #RankIC #开源量化 #QuantSkills #AI量化 #因子挖掘 #ICIR #交易成本 #量化回测 #量化研究 #A股
Be First to Comment