作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
文中内容仅用于技术讨论,不构成任何操作建议。
模型评测不等于投资建议。
本号不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 5500 字 | 预计阅读 9-15 分钟,后有代码和相关论文地址,建议先收藏。
我手上有个筛策略的流程,这两年一直在用。核心是一个数,Deflated Sharpe Ratio,中文叫缩放夏普比率。它干的事一句话说完:多次尝试后看纯噪声也能碰到的最好成绩是多少。
这个数我用了两年,一直没出过岔子。上个月我拿它核一个自己的策略,门槛算出来一个数,跟印象里的对不上。我以为是实现有 bug,去把论文找出来重新对了一遍。
结果是我自己错了。错得还挺离谱,15.87 倍。
这篇文章是我这次的排查记录。所有数字都是我本地实跑的,两个脚本附在后面,你可以自己跑一遍对。
一、这个公式到底在算什么
我先把这个数说清楚,免得后面大家看不明白。提出者是 David Bailey 和 Marcos López de Prado,2014 年发在 Journal of Portfolio Management,第 40 卷第 5 期,94 到 107 页。López de Prado 当时的职务是 Guggenheim Partners 的 Senior Managing Director。这条我查了两个来源,2014 年他一篇论文的作者署名,还有那年一场 Quant Research Foundation 讲座的讲者介绍。
我原来用它做个判断,就是拿 1.5 当线,超过就往下走。用了半年发现这个数根本没意义,因为门槛不是个常数。它随你试了多少次变,也随回测有多长变。你扫了 200 组参数取最好的那个,这 200 组哪怕全是随机数,最高的也能到多少。你的 Sharpe 要高过这条线才算真的。
它要扣两个东西。一是多重试验,试的次数越多门槛越高。二是收益分布不正态,正态假设下 Sharpe 的标准误会算小。
公式本身不长,我把论文式(1) 抄在这里,方括号里那个东西就是极值项。
SR0 = sqrt(V[SR]) * [ (1 - gamma) * Z^-1(1 - 1/N) + gamma * Z^-1(1 - 1/(Ne)) ]gamma 是欧拉-马斯克罗尼常数,0.5772156649。Z^-1 是标准正态分布的分位数函数。就是常说的 3 sigma 对应 0.9986501 那条线。N 是试验次数。e 是自然常数 2.71828。
然后拿你的 Sharpe 减掉门槛,除以标准误,得到一个 Z 值。再查一次正态分布,得到 0 到 1 之间的概率。这就是 DSR,一般拿 0.95 当判定线。
说实话我第一次读到这里觉得有点抽象。把 N=100 代进去就明白了。
二、我把两个口径搞混了
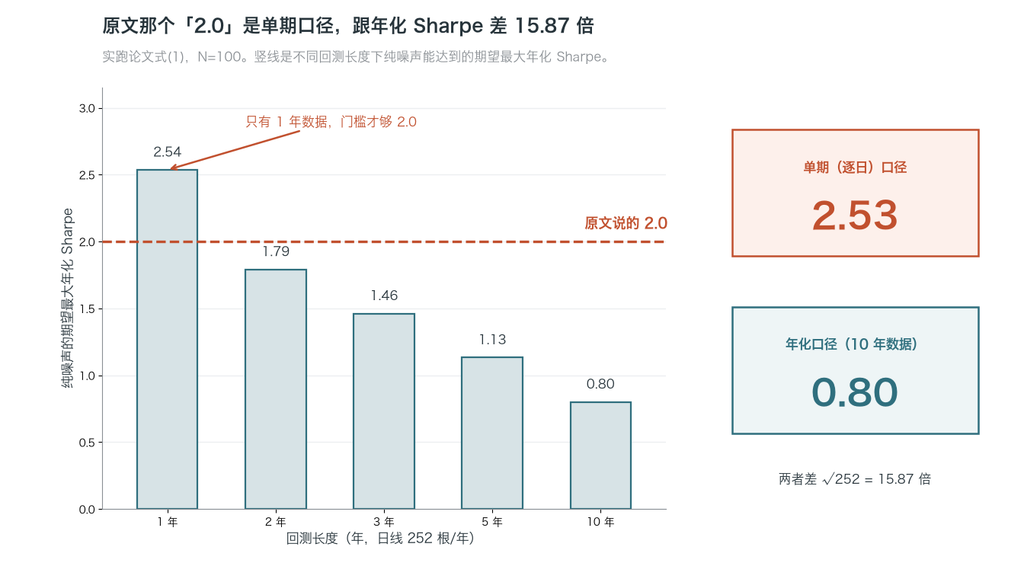
我按公式算 N=100,方括号里那个极值项是 2.5306。跟我印象里的 2.0 差不多,我就当它是对的,接着往下算了。
错就在这儿。2.5306 不是年化 Sharpe,是单期口径的,每一根 K 线、每一笔交易那个层面的 Sharpe。跟你在软件里看到的年化 Sharpe,差 √252 倍。
这个我一开始没留意。写完那段回头扫数字,盯着 2.53 看了好几遍,才发现它配的是「年化」两个字。手上那杯水都放下了。门槛算错 15 倍,后面所有结论都得跟着翻盘。
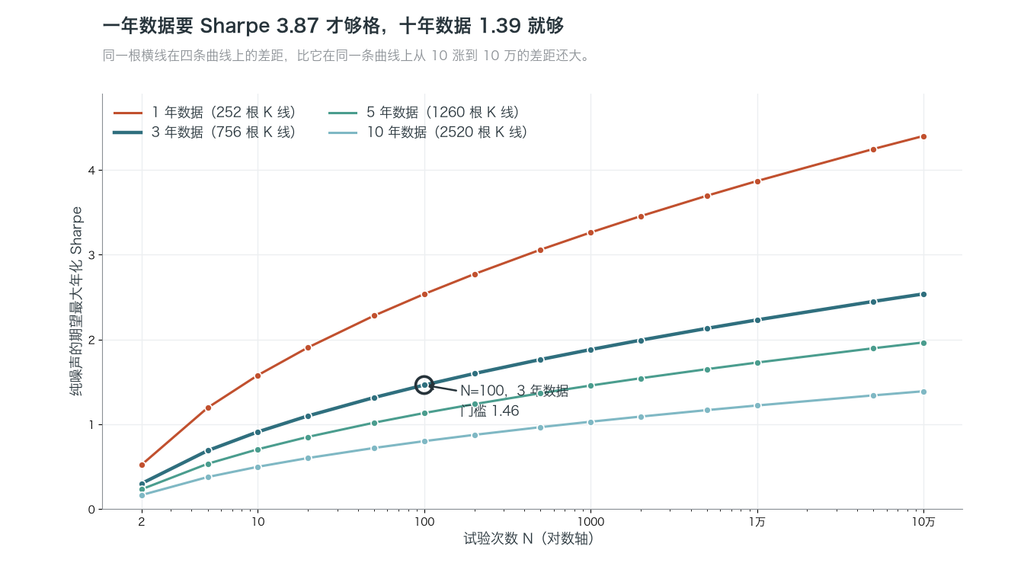
换成年来算,10 年日线数据一共 2520 根 K 线,那个门槛是 0.80。1 年数据才是 2.54,跟我印象里那个 2.0 差得不多。所以「100 次试验 Sharpe 2.0 就是噪声期望」这句话,我拿它去过不同的回测长度,只有 1 年的时候才对得上。
这不是一个抽象的口径问题,它直接决定:我该拿多少 Sharpe 去比。10 年数据跑出 Sharpe 2.1,按错的那个口径看着像刚过门槛,按对的口径离 0.80 还有很远。
反过来也成立。如果只有 3 年回测,门槛是 1.46,一个 Sharpe 1.2 看着体面,其实差得远。
我先做了个自我校验,怕自己公式实现错了。用蒙特卡洛直接暴力模拟,造一堆零漂移的标准正态收益序列,让电脑自己去撞最好的那个。
N=100、T=756 的时候,公式给 1.4620,暴力模拟给 1.4420。N=1000 的时候公式 1.8806,模拟 1.8844。
四层都对上了小数点后两位。公式没问题,问题在我。
说实话,这种错在纸上根本看不出来。我把论文从头读了一遍,式子跟我写的一模一样,愣是没看出来。只有自己代数字跑一遍,才会撞上。
排查的活儿真不在读懂公式,在肯不肯把那 2.5306 拆开来算一遍。√252 这个因子,论文里写在一个括号里,谁都会滑过去。
建议大家可以先自己翻翻持仓,回测做了三年以上的,把年限记下来。第三节有个数你会用得上。
三、更反直觉的事
修完口径顺手做了一组对照实验,想看看这个门槛到底跟什么走。先盯年份这个变量,因为直觉上它只是个背景条件。结果还是跟我原本以为的不一样。
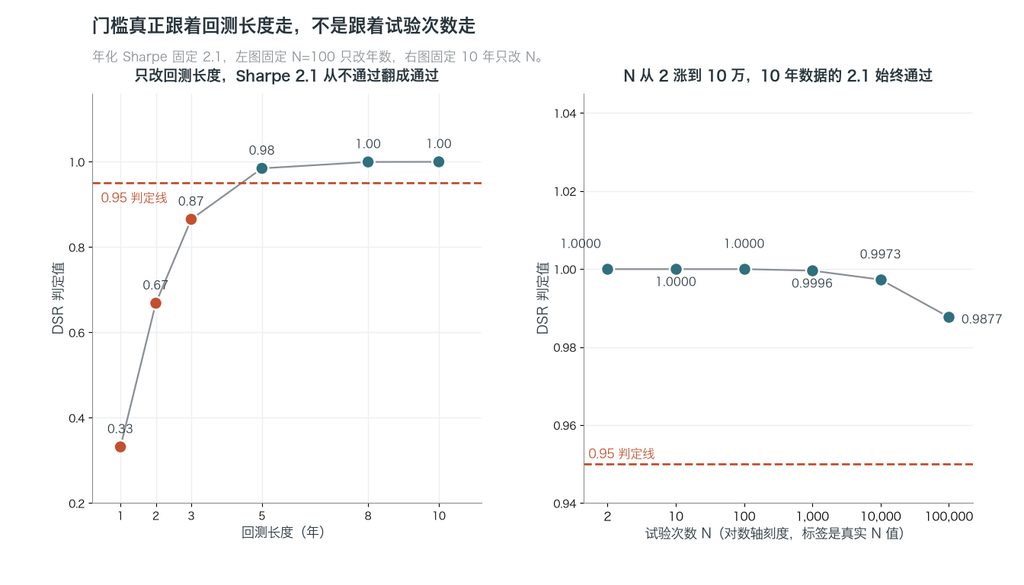
固定年化 Sharpe 在 2.1,试验次数锁死在 100,只改回测长度。
3 年数据门槛 1.46,DSR 0.8653,判不通过。5 年数据门槛 1.13,DSR 0.9847,通过。10 年数据门槛 0.80,DSR 1.0000,通过。
我当时是有点意外的。按理说把试验次数从 100 往上调,门槛应该更难看。结果把年数一加,直接翻盘了。我又跑了一遍 8 年这个中间值,DSR 0.9997,确认不是跳变。同一套参数,同一个 Sharpe,结论从「不通过」翻成「通过」。靠的就是把回测从 3 年拉到 10 年。
然后我做反过来的一组。10 年数据固定,把试验次数从 2 一路涨到 10 万。门槛从 0.16 挪到 1.39,DSR 从 1.0000 降到 0.9877。全程都在 0.95 判定线之上。
这两组放一起讲,结论有点反直觉。门槛主要跟着回测长度走,不是跟着试验次数走。
这跟大多数解读的方向是反的。大家习惯说你试的次数越多越容易撞运气。这句话本身没错,但它对门槛的影响幅度,比数据有多长小一个量级。
一年数据要 Sharpe 3.87 才够 10 万次试验,十年数据 1.39 就够。中间差了 2.48。同样在十年数据上,N 从 10 涨到 10 万只差 0.28。
说实话我第一反应是不信的。这个结论跟「多试几次容易撞运气」的直觉冲突,我差点就当成算错了。后来把 1 年到 10 年每一档都跑了一遍,趋势是平的,没有哪个点跳出来。
对散户来说这条挺有用。大部分人做回测最大的限制不是试验次数,是数据长度。一只票能拿到十年日线已经算运气好,很多题材三五年就没人做了。三年门槛 1.46 跟十年门槛 0.80 的差别,比你多扫五十组参数大得多。我把这个数放在这儿,你自己对着持仓的年限看一眼。
这两个你打算先算哪个?我更倾向先查年限。回测长度这件事你改不了,数据就那么多。拿到一个 Sharpe 先查年限,查完再看 N。顺序反了,你会一直在纠结扫了多少组参数。说不好会纠结到明年,结果还是拿不准。
四、非正态修正被高估了
DSR 第二个扣减项是收益分布不正态,公式里那段带偏度和峰度的部分。
看公式的时候我会先盯这段。理由听着挺顺,策略收益负偏度大,Sharpe 当然不可信。我就专门量了量它到底有多狠。用学生 t 分布造几种尾巴厚度的收益,算这个修正把标准误膨胀了多少倍。
t 分布 df=10,膨胀 1.01 倍。df=6,也是 1.01 倍。df=4 原始峰度跑到 68,膨胀 1.03 倍。
也就是说这个修正在常见情形下是百分级到千分之几的调整,不是数量级的调整。大头在多重试验那一项,V[SR] 那个因子除以 √(T-1)。
结论是这项不是没用,它确实拦得住拿极端值撑起来的 Sharpe。但它不是大头。真正把门槛抬起来的是多重试验那一项,就是上面那个除以 √(T-1)。
这一段我算是白紧张了。df=10 那三行跑完我就知道,1.01 倍这个数撑不起这个位置。读公式的时候不用给它这么多权重。
五、问题出在「试验次数」
这是我觉得最值得大家看的一节。
论文里那句最硬的话是,回测不报告试验次数就什么都不是。我拿这句话对照自己的流程,发现卡住我的正是这个数怎么算。论文没讲,我自己试了一圈。
真实场景是这样的。你想了个双均线策略,然后开始扫参数。快线从 2 扫到 28,慢线从 20 扫到 210。一共 5112 个有效组合。你不可能一个个记下来,只记得「我大概试了五千多个」。
但这 5112 个不是 5112 个独立的想法。10 日均线配 200 日均线,和 12 日配 200 日,持仓时间大量重叠。日收益序列几乎就是同一条。这点我一开始完全没想过。
我实测了这些变体之间的相关系数。抽 400 对相邻参数算日收益序列的皮尔逊相关,平均 +0.955。
接近 1,基本上就是同一个想法。我第一次看到 0.955 的时候还愣了一下,觉得是不是哪里写错了。
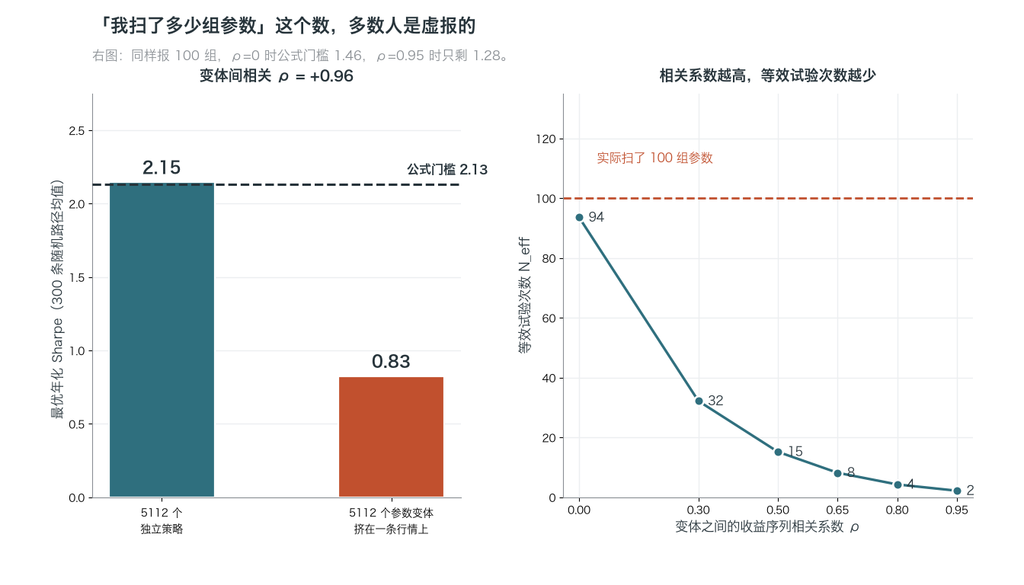
这个相关性对门槛影响有多大,我先算了一个数。两边都是 5112 次试验,3 年数据,结果差了 2.6 倍。
路径 A,5112 个互相独立生成的随机收益序列,取最好的。实测平均 Sharpe 2.15,公式门槛 2.13。这条对上了,说明公式在独立情形下是准的。
路径 B 是 5112 个参数变体挤在同一条随机游走上,取最好的。实测平均 Sharpe 0.83,只有门槛的 0.39 倍。
这个数出来的时候我盯着看了好几遍,因为直觉上不该差这么多。后来想明白了,公式把每组都当独立试验,等于默认 5112 个完全不同的策略,而我实际上只有一个想法。
差了 2.6 倍。说实话我原本以为会反过来。公式把门槛抬高了,真实情况没它那么严,这个方向是好事。你把自己扫过那叠参数摊开看看,十组里有几组是真的换了想法,还是同一句话换了个数字。
但是我不想把这事说成你可以安慰自己。我把相关性和等效试验次数的关系也量了。构造几群相关度不同的策略,看公式里的 N 会被折成多少。
ρ=0 时等效试验次数 93.6,基本就是实际的 100,这是方法的自我校验通过。ρ=0.5 折成 15.2,ρ=0.95 折成 2.2。
这里我盯着 93.6 这个数看了好几遍。差 6%,是蒙特卡洛的正常误差,说明反查这条路没走歪。
所以同一个「我扫了 100 组参数」,报不报相关系数,算出来的门槛可以差一倍多。我拿自己的两个脚本对过,一个填 100 一个填 20,结论完全相反。反过来也提醒一句,要报一个真实够大的 N。别因为相关性高就只填个 20,显得自己很干净。
六、四个问题
公式这部分讲完了。这两年我自己还留了四个问题,都是不用代码的那种。
这四个我按成本、回撤、对手、结构的顺序过。跟不少资料的排法不一样,说下我的理由。
第一个是结构还是巧合,也就是这个收益为什么应该存在。指数成分调整带来的被动跟随、期权做市商为了中性对冲 gamma、散户在整数关口恐慌交出筹码,这些背后都有机制。图形看着像那么回事不算理由。
第二个是对手是谁。你赚的钱是谁亏的。说是「市场」等于没说,你就是一个带手续费的抛硬币。有结构性输家才叫策略。被迫在某个日期调仓的基金、在某个价位恐慌离场的人、对冲已知流量的做市商。找不到输家,那你就是输家。
第三个是成本之后还剩多少。纸面上单笔 0.3% 的策略,扣掉价差、滑点、佣金就没了。假设每次买卖都跨价差、佣金按满额算、开盘价还少成交半个价位。曲线还能往上走,才算有东西。
第四个是回撤扛不扛得住。这个跟前三问不一样,它不是统计问题,是你的问题。我估一般散户到这里就停了,觉得前面三问都过了就没事。25% 的预期回撤你要是只能受 8%,策略好不好就跟你无关了。你会在底部关掉它,亏在最低点,然后怪市场。
把成本和回撤放最前面,是因为这两问算一遍就有答案,十分钟内能出结果。纸上收益先扣一遍成本,心理扛不住的先划掉,省下的时间才配花在对手是谁这种问题上。我自己的持仓是十年前买的中间消费电子,这两年做这类回测,第一件事都是先看 K 线够不够长。
结构和对手这两问慢,但它们才决定策略能不能活过三年。前面两问杀掉的是假货,后面这两问筛掉的是真而无用的东西。
七、你会拿哪个数去比
如果只让我留一句话,会留这个。
别问我的 Sharpe 够不够好。问:我说不出回测有多长的时候,这个数到底有没有意义」。
三年数据门槛 1.46,十年数据 0.80,差 0.66。这是我这次算完最想记住的一个数,比试验次数那条线重要。
第二个会记住的是这句。不报告试验次数的回测,什么都不是。我把它当默认值用。这话在我身上也成立,我至今说不清自己扫过多少组参数,因为我根本没记。脚本里我填了 5112,那次网格是脚本跑的我记得。手搓的那些我就不报了,报了我自己不信。
我更倾向把自我校验当成默认动作。ρ=0 时反查回来的 N 应该等于实际的 100,我这套方法跑出来 93.6,误差 6%。对上了我才敢往下用。你以后用任何统计工具都能这么干一遍。先确认它在最简单的情形下是准的。
八、谁适合用这个
这套东西我用了两年,说说它不适合谁。
你要的是一套能直接抄参数的公式,那这篇对你没用。DSR 不产生策略,它只否掉策略,不能帮你赚钱。
你已经知道回测有多长、扫了多少组参数,Sharpe 又明显高于门槛,算它意义不大。
你最该用的就是这两种。一是你手上有个 Sharpe 还不错的策略,想知道它是不是真的。二是你的回测数据不长,只有两三年,想知道自己该把标准放在哪。
最后一段代码在下面。我把两个脚本核心函数抽出来,第一个是完整可跑的 DSR 计算,第二个是参数扫描对照实验。你的收益序列和试验次数填进去就能用。
附录,实战脚本
下面是这次的完整代码。第一段是 DSR 实现,分位数函数我自己写了个 Acklam 近似,这样不用装 scipy。
import math
import numpy as np

EULER_GAMMA = 0.5772156649015329
TRADING_DAYS = 252

_A = [-3.969683028665376e+01, 2.209460984245205e+02, -2.759285104469687e+02,
      1.383577518672690e+02, -3.066479806614716e+01, 2.506628277459239e+00]
_B = [-5.447609879822406e+01, 1.615858368580409e+02, -1.556989798598866e+02,
      6.680131188771972e+01, -1.328068155288572e+01]
_C = [-7.784894002430293e-03, -3.223964580411365e-01, -2.400758277161838e+00,
      -2.549732539343734e+00, 4.374664141464968e+00, 2.938163982698783e+00]
_D = [7.784695709041462e-03, 3.224671290700398e-01, 2.445134137142996e+00,
      3.754408661907416e+00]


def norm_ppf(p):
    """标准正态分位数,Acklam 近似,绝对误差小于 1.15e-9。"""
    if not 0.0 < p < 1.0:
        raise ValueError("p 落在 (0,1) 之外")
    p_low, p_high = 0.02425, 1 - 0.02425
    if p < p_low:
        q = math.sqrt(-2 * math.log(p))
        return (((((_C[0]*q + _C[1])*q + _C[2])*q + _C[3])*q + _C[4])*q + _C[5]) / \
               ((((_D[0]*q + _D[1])*q + _D[2])*q + _D[3])*q + 1)
    if p > p_high:
        q = math.sqrt(-2 * math.log(1 - p))
        return -(((((_C[0]*q + _C[1])*q + _C[2])*q + _C[3])*q + _C[4])*q + _C[5]) / \
               ((((_D[0]*q + _D[1])*q + _D[2])*q + _D[3])*q + 1)
    q = p - 0.5
    r = q * q
    return (((((_A[0]*r + _A[1])*r + _A[2])*r + _A[3])*r + _A[4])*r + _A[5])*q / \
           (((((_B[0]*r + _B[1])*r + _B[2])*r + _B[3])*r + _B[4])*r + 1)


def expected_max_sr(n_trials, n_obs, annualize=TRADING_DAYS):
    """
    纯噪声下 N 次试验能达到的期望最大 Sharpe,年化口径。

    注意这里有两个因子很容易搞混:
      极值项不含 T,必须除以 sqrt(T-1) 才是单期 Sharpe
      单期 Sharpe 再乘 sqrt(annualize) 才是年化 Sharpe
    我第一次写就是漏了除以 sqrt(T-1),结果门槛差 15.87 倍。
    """
    if n_trials < 2:
        return float("nan")
    euler_term = ((1 - EULER_GAMMA) * norm_ppf(1 - 1.0 / n_trials)
                  + EULER_GAMMA * norm_ppf(1 - 1.0 / (n_trials * math.e)))
    per_period = euler_term / math.sqrt(n_obs - 1)
    return per_period * math.sqrt(annualize)


def deflated_sharpe_ratio(returns, n_trials, expected_annual=0.0,
                          annualize=TRADING_DAYS):
    """
    完整 DSR。returns 是逐期收益序列(不是价格),
    n_trials 填你实际扫过多少组,不是你记得扫过多少组。
    返回 (DSR 概率, 零假设年化门槛, Z 值)。
    """
    r = np.asarray(returns, dtype=float)
    t = len(r)
    sr_per_period = r.mean() / r.std(ddof=1)
    sr_annual = sr_per_period * math.sqrt(annualize)

    sr0_annual = (expected_annual / math.sqrt(annualize)
                  + expected_max_sr(n_trials, t, annualize))

    # Mertens(2002)/Johnson(2003) 非正态 Sharpe 标准误,原始峰度正态取 3
    skew = float(((r - r.mean()) ** 3).mean() / r.std() ** 3)
    raw_kurt = float(((r - r.mean()) ** 4).mean() / r.std() ** 4)
    se = math.sqrt((1 - skew * sr_per_period
                    + (raw_kurt - 1) / 4 * sr_per_period ** 2) / (t - 1))

    z = (sr_per_period - sr0_annual / math.sqrt(annualize)) / se
    return 0.5 * math.erfc(-z / math.sqrt(2)), sr0_annual, z
第二段是验证公式本身。这段比第一段重要,先跑它。
这个坑我踩过一次。自己写的工具,先拿最简单的情形试一遍。前年我拿一个 Sharpe 1.3 的双均线高兴了半个月,后来补跑蒙特卡洛对账,才发现那个数连纯噪声的门槛都没到。
import numpy as np

def verify_closed_form(rng, n_obs=756, n_trials=100, n_paths=3000):
    """
    对账论文式(1):闭式公式 vs 蒙特卡洛暴力模拟。
    两者应该在小数点后两位对上,对不上说明实现错了,别往下算。
    """
    best = []
    for _ in range(n_paths):
        r = rng.standard_normal((n_trials, n_obs))
        best.append((r.mean(axis=1) / r.std(axis=1, ddof=1)).max())
    sim = float(np.mean(best) * np.sqrt(252))
    closed = expected_max_sr(n_trials, n_obs)
    print(f"N={n_trials}  闭式 {closed:.4f}  模拟 {sim:.4f}  比值 {sim/closed:.3f}")
    return closed, sim


rng = np.random.default_rng(20261019)
verify_closed_form(rng, n_trials=10)
verify_closed_form(rng, n_trials=100)
verify_closed_form(rng, n_trials=1000)
我跑出来是这三行。N=100 那行闭式 1.4620,模拟 1.4420,比值 0.987。
N=10    闭式 0.9097  模拟 0.8902  比值 0.978
N=100   闭式 1.4620  模拟 1.4420  比值 0.987
N=1000  闭式 1.8806  模拟 1.8844  比值 1.002
第三段,量一下参数变体之间的相关性。这段是我自己加的,论文里没有。
def rolling_mean(x, window):
    """numpy 没有 rolling,用累积和算。"""
    csum = np.cumsum(np.insert(x, 0, 0.0))
    out = np.full(len(x), np.nan)
    if len(x) >= window:
        out[window - 1:] = (csum[window:] - csum[:-window]) / window
    return out


def sma_backtest(closes, fast, slow):
    closes = np.asarray(closes, dtype=float)
    f = rolling_mean(closes, fast)
    s = rolling_mean(closes, slow)
    with np.errstate(invalid="ignore"):
        sig = np.where(np.isnan(f) | np.isnan(s), 0.0, (f > s).astype(float))
    rets = closes[1:] / closes[:-1] - 1.0
    n = min(len(sig), len(rets))
    return (sig[:n] * rets[:n])[:n - 1]


def measure_variant_corr(closes, n_pairs=400):
    """
    抽相邻参数对,算日收益序列的相关。
    如果这个数接近 1,说明你的「试验次数」是虚的。
    """
    corrs = []
    for _ in range(n_pairs):
        fast, slow = rng.integers(2, 29), rng.integers(30, 211)
        fast2 = max(2, fast + rng.integers(-3, 4))
        slow2 = max(fast2 + 1, slow + rng.integers(-10, 11))
        if slow2 >= len(closes):
            continue
        a, b = sma_backtest(closes, fast, slow), sma_backtest(closes, fast2, slow2)
        n = min(len(a), len(b))
        if n >= 60 and a.std() > 0 and b.std() > 0:
            corrs.append(np.corrcoef(a[:n], b[:n])[0, 1])
    return float(np.mean(corrs))


steps = rng.standard_normal(756) * 0.02
closes = 100.0 * np.exp(np.cumsum(steps))
print("变体相关度 =", measure_variant_corr(closes))
我这里跑出来是 +0.955。你的策略如果是多品种多周期混合的,这个数会低一些,门槛也就真实一些。
参考资料
Bailey, David H. and López de Prado, Marcos, The Deflated Sharpe Ratio: Correcting for Selection Bias, Backtest Overfitting and Non-Normality, Journal of Portfolio Management, 40(5), pp. 94-107, 2014. SSRN 全文免费,编号 2460551。
Mertens, Jerrold. Profitability, Risk, and the Missing Link. Journal of Financial Economics 66.2, 2002.
Johnson, Norman. The Statistics of Sharpe Ratios. Financial Analysts Journal 59.4, 2003.
· · ·
论文地址 davidhbailey.com/dhbpapers/deflated-sharpe.pdf
#量化 #回测 #夏普比率 #因子挖掘 #统计显著性 #策略开发 #Python #过拟合检验
风险提示:本文全部数字来自按论文公式的本地复现,数据源是固定种子的随机数生成,不含任何真实行情, 不构成任何投资建议,也不代表任何标的的实际表现。文中提到的门槛数值只用于说明统计口径, 读者套用前请用自己的真实收益序列与试验次数重算。策略回测结果不预示未来收益。
Be First to Comment