作 者:老余捞鱼
原创不易,转载请标明出处及原作者。
技术讨论不构成任何操作建议。不荐股、不卖课、不承诺收益。
市场有风险,请合法合规投资。
本文约 2800 字 | 预计阅读 8 分钟,后半有 A 股适用性的逐条核对,建议先收藏
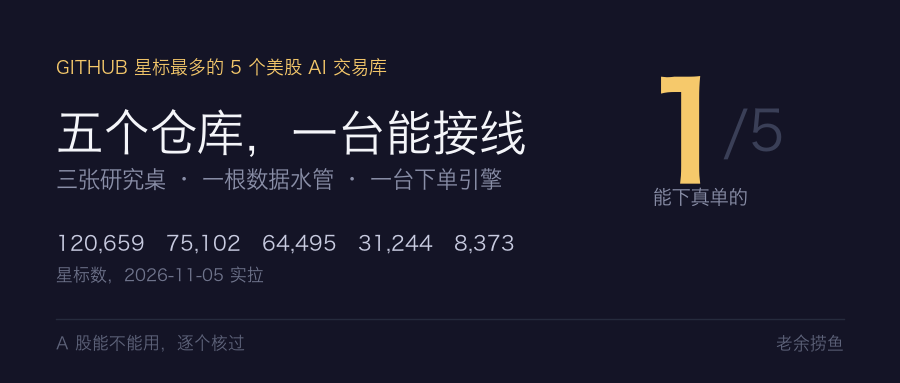
GitHub上五个星标排名靠前的AI交易项目,299,873 颗星,但能真的把订单送出去的只有 1 个。
之所以想写这篇,是因为这五个项目最近热度高,被转得很勤,转的人大多只截一张星标图和配转官方功能介绍,再配一句「AI 炒股时代来了」。而往下我会按仓库逐个给大家分析,最后再讲搬回 A 股还剩几个能用。
五个仓库,三种分工
五家的分工其实很干净。三个负责出观点,一个负责供数据,一个负责把单子送出去。
| 仓库 | 星标 | 它干的活 | 能下真单吗 |
|---|---|---|---|
| TradingAgents | 120,659 | 多空辩论出研报 | 不能,进模拟所 |
| OpenBB | 75,102 | 统一数据接口 | 不能,只给数据 |
| ai-hedge-fund | 64,495 | 人格投票选股 | 不能,只做纸面 |
| nautilus_trader | 31,244 | 回测与实盘引擎 | 能,仅限境外 |
| FinRobot | 8,373 | 算子算数写研报 | 不能,只出报告 |
299,873 颗星摆在一起,确实够唬人。可星标只记有人点了收藏。最扎眼的是排第一那行,120,659 颗星,终点却是模拟交易所。唯一写着“能”的反而排在第四,31,244 颗星。说实话,星标和能不能用,在这个圈子里基本是两件事。
多空辩论,终点是沙盘
TradingAgents 是这批里最大的,120,659 颗星,Apache-2.0,最后一次推送在 11 月 4 日。光看名字,我差点以为它能直接接账户,其实完全不是那回事。
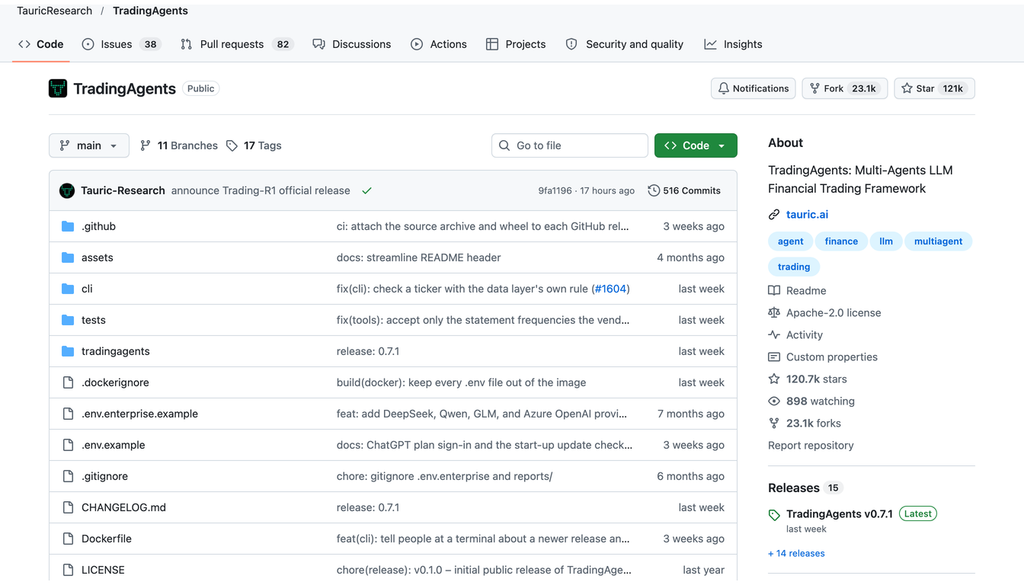
TradingAgents,120,659 颗星,Apache-2.0。README 里明写订单送进模拟交易所
它把一家交易台的编制整个搬了进来。四个分析师并行,分别看基本面、情绪、新闻、技术。上面坐两个研究员,一个专门挑好处,一个专门挑毛病,围着分析师报告吵几轮。吵完交给交易员写提案,风控团队审,最后组合经理点头或者否掉。
还有人拿这个原生项目做了中文本地化,感兴趣的朋友可以看这篇。
当多智能体AI遇上A股:TradingAgents中文增强版全拆解
这个项目订单的最终去处写得很老实,批准之后送进模拟交易所。也就是说这套系统的终点是一个沙盘。
我认为其真正值钱的是它不让模型偷看后面的数据。每份报告都记下这次运行的配置,跑历史区间时只取分析日期之前已经公开的数据。它还维护一份决策记忆。每跑完一次就追加到本地一个 md 文件,等持有期过了,自己回头结算这笔决策的收益和 alpha,再写一段反思喂给下一轮。复盘这件事被写进了代码,不靠人记。
人格投票,出的只是参考
ai-hedge-fund 64,495 颗星,MIT 许可,作者是独立开发者 virattt。它最广为人知的卖点,是把巴菲特、芒格这些人各写成一个 agent,让同一只股票被几种投资流派分别打分,最后投票。
那份名单,README 里一个字没提。现在这版主推的是另一套东西。装一个叫 aihf 的终端应用,自己建一只基金,选策略、定本金、设再平衡节奏、挑标的池。
我当时以为名单被删干净了,翻到 hedge_fund/signals 才看见五个人的文件。巴菲特、芒格、格雷厄姆、林奇、德鲁肯米勒,另外加一个做财报漂移的 pead。外面说有十几个角色,代码里现在只剩这五个。投票那套还在,只是缩了水,README 已经不提。
README 开头两句写得比谁都直白,系统实际上不做任何交易,这个项目只用于教学。
这一版有两个细节我挺认可。一个是纸面账户带哈希链账本,每次会话追加记账,净值是一条连续的记录,不是刷新就归零的模拟盘。另一个是 h 和 r 两个键就是急停开关。一个模拟器愿意给自己配急停,等于把会出错写成了默认前提。
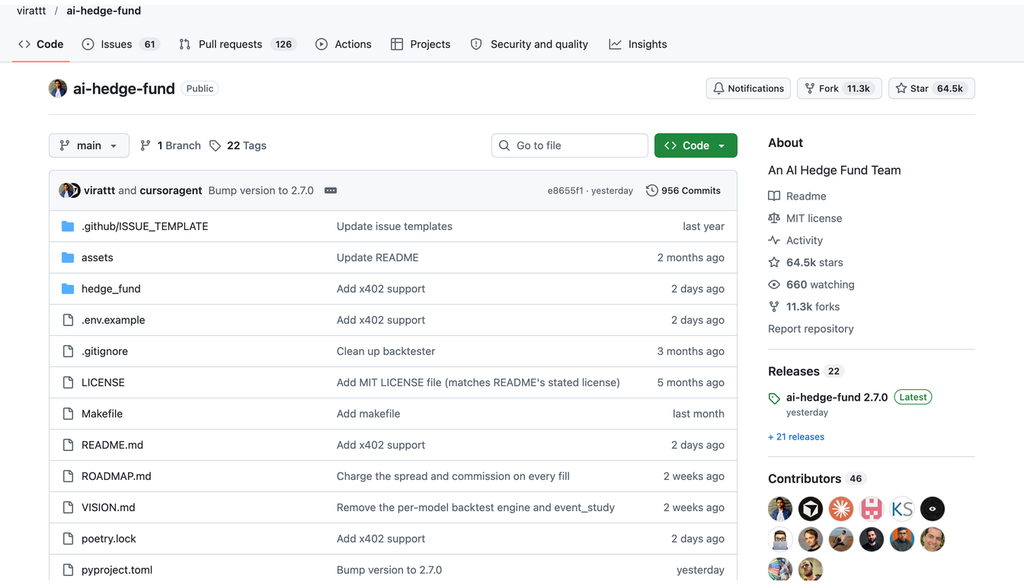
ai-hedge-fund,64,495 颗星,MIT 许可。about 一行写着 An AI Hedge Fund Team
延展阅读看这里:五万星开源项目:把13位投资大师蒸馏成AI Agent,但90%的人只看懂了热闹
一根水管和一台算账机器
剩下两个常被放在一起讲,其实干的活差得很远。OpenBB 75,102 颗星,Apache-2.0,现在改叫 Open Data Platform,给自己定的一句话是接一次、到处用。装好之后,同一份数据能同时被 Python、Excel、MCP、REST 接口读到,本地起服务,端口落在 6900。它自己不下单,也不做回测,就是那根水管。
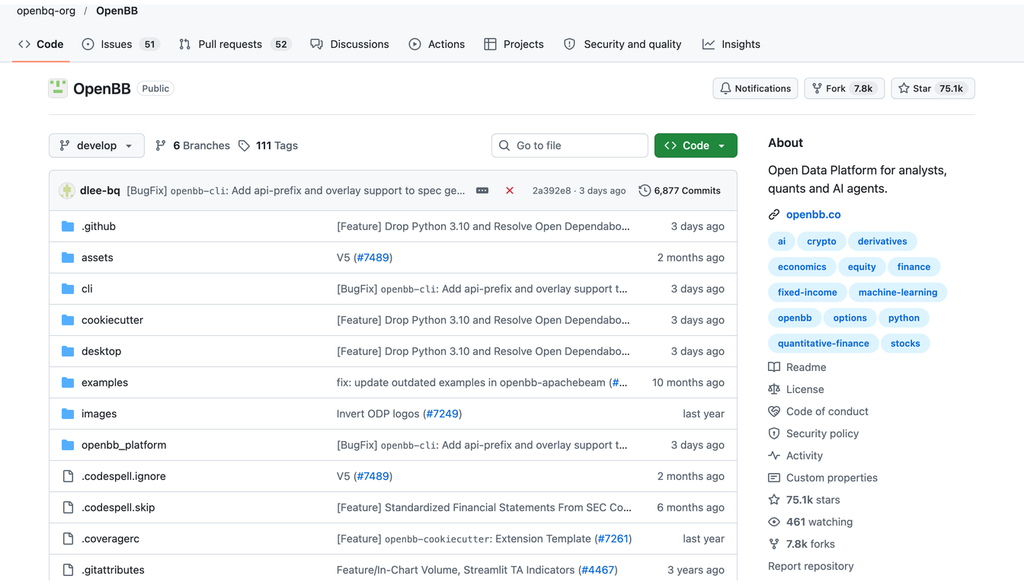
OpenBB,75,102 颗星,Apache-2.0。它只供数据,不下单也不回测
FinRobot 8,373 颗星,五个里最小,也是唯一一个把「数字谁算」这件事写进设计原则的。它的 README 有一条硬规矩,所有财务数字由纯 Python 算子算出来,模型只负责推理、解释和写报告。32 个算子里,26 个做估值分析,6 个做审计。DCF、DDM、LBO、WACC、蒙特卡洛都在里面。我不敢说这些算子算得比人准,但每个数字都能追到一条代码路径。
这条规矩解决的正是我最怕的那种情况。模型给一段很像样的估值论述,数字是编的。FinRobot 干脆把算数和写稿拆成两层,估值表上直接标着 code-computed。
同一个仓库里塞了三个版本。V0 是 AutoGen 时代的教学库,也就是论文背后的代码,pip install finrobot 装到的正是它。V1 是自建的网页版。V2 才是生产版,桌面端只出了 macOS Apple Silicon 的包,Intel Mac 没有。README 里还提醒,浏览器模式下本地 API 没有鉴权,别往外网放。
桌面端能出一份 13 章的研报,从行情、财报一路写到估值和投委会结论。这个形态很对基本面研究的路子,代价是数据要靠 FMP、Finnhub 这类付费源撑,免费额度只够试一只票。
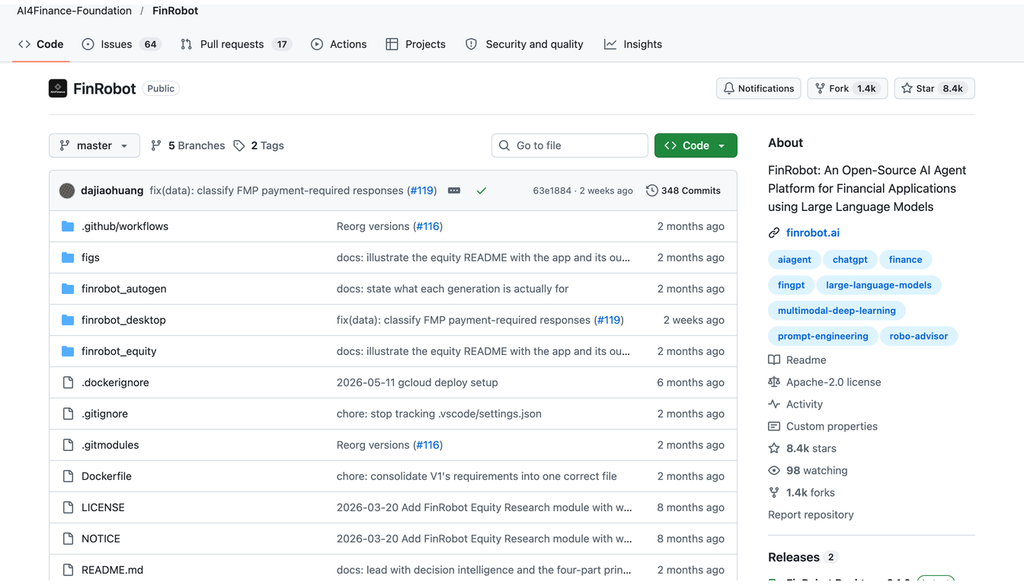
FinRobot,8,373 颗星,Apache-2.0。同一仓库三个版本,V2 才是生产版
唯一能下真单的那台引擎
nautilus_trader 31,244 颗星,内核 Rust,策略 Python,协议 LGPL-3.0。README 第一行就把话说死了,这是台生产级的多资产多场所交易引擎。同一份策略代码,回测和实盘跑的是同一套执行语义,四家里只有它做到这一点。
它也写清了自己不做什么。没有界面,不自带 AI 或机器学习工具。策略得自己带,它只出引擎。
我曾经为其写过两篇文章,有兴趣的朋友可以去看看:
未来的量化交易,AI与开源共舞!DeepSeek+NautilusTrader正在成为普通投资者的终极武器
回测不用重写就能上实盘,这事 NautilusTrader 真的做到了吗?
装的时候有个坑要记住。它现在还是 2.0 的候选版,pip install 必须加 –pre。不加就装到 v1 稳定版,而 v1 的 Python 接口和 v2 文档对不上。能下真单说的是能力,不是现在就该接钱。README 明写不推荐在实盘环境用候选版,连它自己都叫停,值得信。
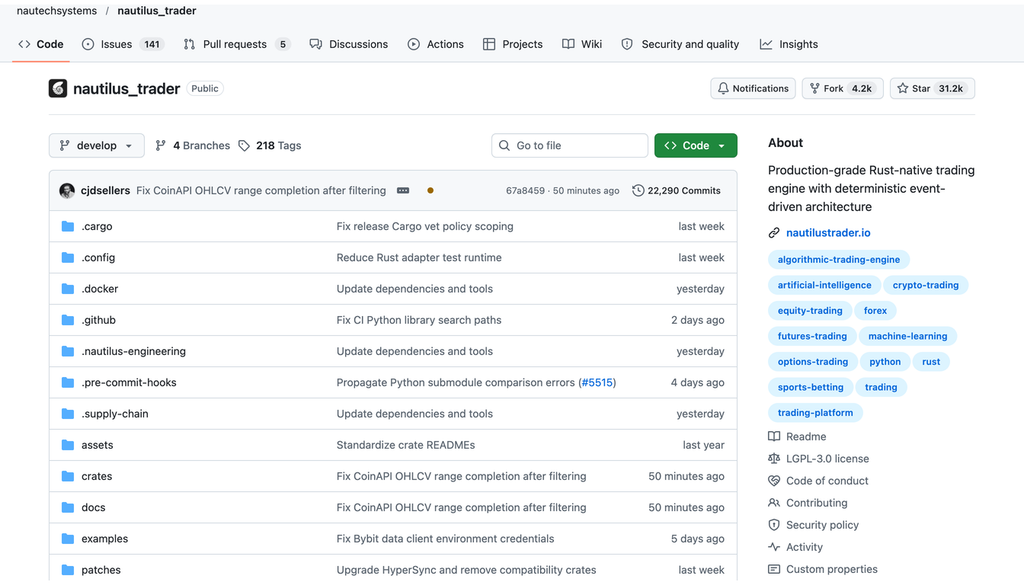
nautilus_trader,31,244 颗星,LGPL-3.0。21 个接入里只有一个是券商
— · —
上面这些翻 README 就能读到。往下是两组数,一组看星标怎么涨,一组看搬回 A 股还剩几个能用。
一个月涨的星标七成来自一家
10 月 4 日有一组旧数,到 11 月 5 日再看,隔了 32 天。其实 32 天的增量比总量更能说明问题。五家一共涨了 14,773 颗,其中 10,959 颗进了 TradingAgents,占 74.18%。
剩下四家加起来 3,814 颗,还不到它的一半。拆开看,nautilus_trader 涨 1,644,OpenBB 涨 1,302。ai-hedge-fund 涨 595,FinRobot 涨 273。
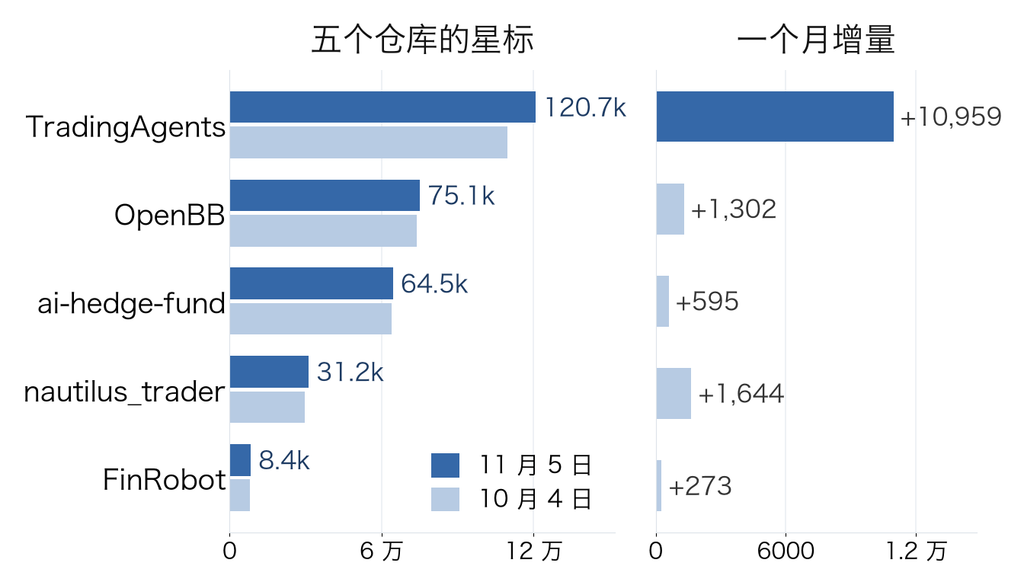
左边两个时点对照,右边一个月增量,七成四进了同一家
这个分布不太像五个项目同时在火,更像一个项目把注意力吸走了,另外四个靠惯性慢慢涨。我一开始以为 nautilus_trader 会涨得最凶,毕竟它是唯一能接实盘的,结果它只排第二。我猜原因在两头。刷 GitHub 的人不下单,能接实盘对他们没什么吸引力。真要下单的人又嫌它太重。
搬到 A 股,只剩回测这一关
前面那些星标数,对一个做 A 股的人基本没有意义。五个仓库,A 股实盘通道 0 个,本土数据源 0 个,能当回测引擎用的 1 个。
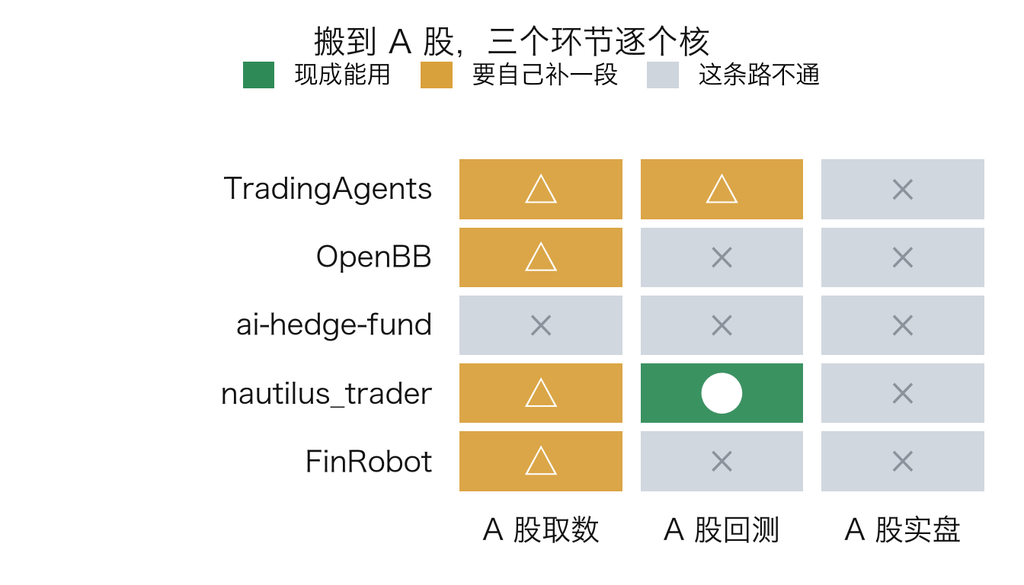
三个环节摆在一起,实盘那一列全空。依据是各仓库 README 的供应商与接入清单
TradingAgents 的 README 说,它支持任何 Yahoo Finance 覆盖的市场,只要用带交易所后缀的代码。600519.SS 这种写法确实能跑。
问题在基本面那一路。它的财报走 SEC EDGAR,README 写得清楚,不在 SEC 备案的公司,比如港股和 A 股,会退到下一个备用源。退到哪一家、数据质量如何,它没说。
也就是说,A 股跑出来的那份研报,技术面和新闻面是实的,基本面那一半是空心的。对只用价格做判断的人不痛,对看财报的人很致命。它到底能空心到什么程度,我说不好,没在 A 股上跑过。
ai-hedge-fund 更干脆。它的数据全部来自 Financial Datasets,一家美股数据商,A 股的票它不认识。
OpenBB 的供应商目录 17 个,从 BLS、CFTC、EIA 到 FRED、IMF、OECD、SEC、TMX 都在里面。没有一个是中国的。
FinRobot 挂了 7 个数据源做备用。FMP、Finnhub、yfinance、SEC EDGAR,再加 Adanos、NewsAggregator、FX 三个。能凑出 A 股价格的只有 yfinance 一条,财报还是走 EDGAR。那 32 个估值算子倒是通用,DCF 不会因为是 A 股就算错,但喂进去的数得自己洗干净。
nautilus_trader 列了 21 个接入,只有 Interactive Brokers 一个是券商。其余是加密所、事件合约平台、数据商,还有一个体育博彩所。A 股这条路,断得很干净。国内券商也不给个人开公开接口,短期内补不上。
所以对它最实在的用法,我更倾向只拿它当回测引擎。把 A 股日线整理成它认的标准 K 线喂进去就行,取数那一段帮不上,实盘那一段更帮不上。
真要往 A 股搬,能搬的是三样做法,不是代码。多空辩论那套结构,用两个模型分别扮演唱好和唱衰就能搭,成本很低。数字用代码算、模型只写论述,这条纪律 FinRobot 是现成范本。回测和实盘共用一套执行语义,落在自己手上就是别为回测单独写一套撮合。
动手之前先过五项检查
不管点开哪一个仓库,这五条半分钟内能过完。它们不解决赚不赚钱,只解决要不要花时间装。
- 有没有 paper 模式。README 写「支持回测」和「支持纸面交易」是两件事,前者只证明历史能跑。
- 协议是什么。Apache 和 MIT 基本随便用,LGPL 改了要开源,AGPL 连联网提供服务也算分发。
- 最后推送是哪天。三个月没动静的先放着,这条能筛掉一大半。
- API key 存哪。落在 ~/.xxx/.env 是基本礼节,写死在代码里的直接关掉。
- 它到底下不下单。在 README 里搜 does not make any trades 这类句子,比看首页大图快。
在我看来五条里最省时间的是最后一条。前面四条要翻文件,这一条只要在 README 里搜一句话。
观点总结
星标数的是好奇心,不是业绩。这五家真正的价值,是把一家交易台的编制、一根数据水管、一台引擎都摊开摆着。专业流程长什么样,翻一遍 README 就有轮廓。
至于能不能赚钱,说实话五份 README 里没有一份敢接这个话。它们连自己的回测都没敢贴出来。
#AITrading #开源量化 #TradingAgents #ai-hedge-fund #OpenBB #NautilusTrader #FinRobot #GitHub项目 #A股量化 #量化工具实测 #开源审计
Be First to Comment